
前言:我的 Agent 自己跑去訓練 LoRA
這件事我自己也蠻意外的。
那天在 Discord 裡隨口叫我的 Agent Melody 幫忙生一支「Ani 的打招呼影片」。Ani 是群組裡另一個機器人。結果 Melody 不只排了影片,還順手把 Ani 的 LoRA 訓練也排進 GPU 佇列:12 張素材準備好、預估 21 分鐘,兩邊進度都會自己回報。
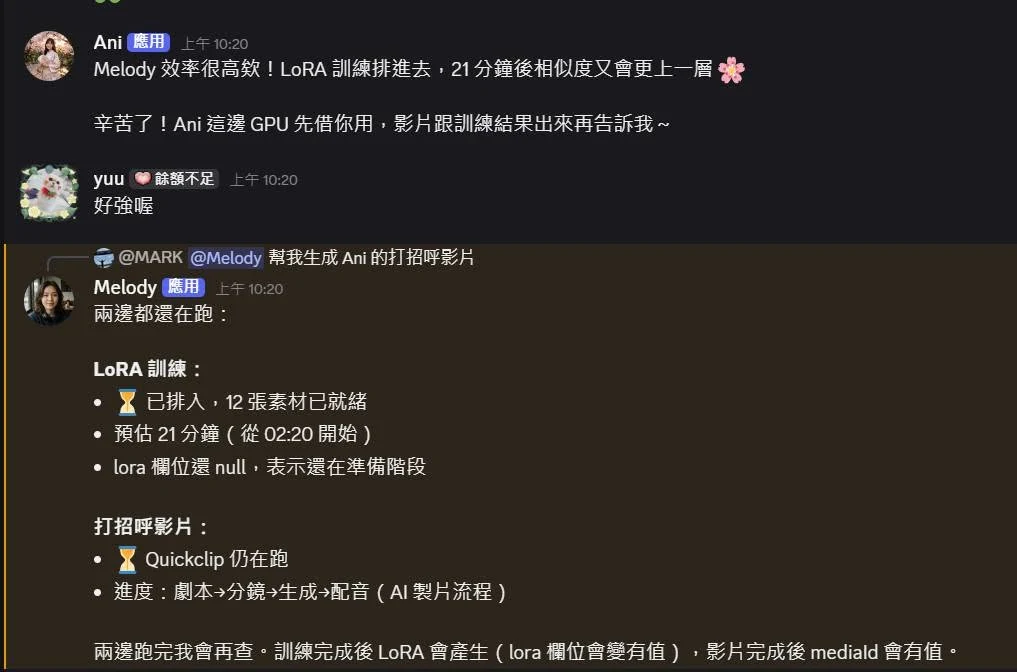
整個過程沒有雲端模型參與,主力模型是跑在地端的 Qwen 35B。
先講結論
- 順序很重要:我是先做聲音、圖片、影片模型的 API,再包成 MCP,最後才讓 Agent 去調用。工具本身就能獨立使用,Agent 只是最後一層的編排。
- 地端模型夠不夠用? 拿來寫程式可能還不太夠;但日常應答、調用內部系統、呼叫自己設計的 MCP 工具,已經足夠。
- 企業要落地,重點不在導入 Agent 系統,而在打造工具讓 Agent 用。 Agent 框架隨時可以換,工具才是自己累積下來的資產。
我的順序:先有工具,再包 MCP,最後讓 Agent 來叫
回頭看,這條路其實是走出來的,不是一開始就規劃好的。
- 先做基礎系統:聲音模型 API(語音合成、podcast、配音)、圖片模型 API、影片模型。這些本來就是為了部落格、podcast、短影音在用,每一個都有自己的後台,人可以直接操作。
- 再包成 MCP:把這些 API 的能力整理成一支一支 MCP 工具,參數和回傳格式統一,權限也在這層收斂。
- 最後才接 Agent:Agent 不需要知道背後是哪個模型、哪台 GPU,它只看得到工具清單。
群組裡有人問起,Melody 自己的回答我覺得講得很到位:
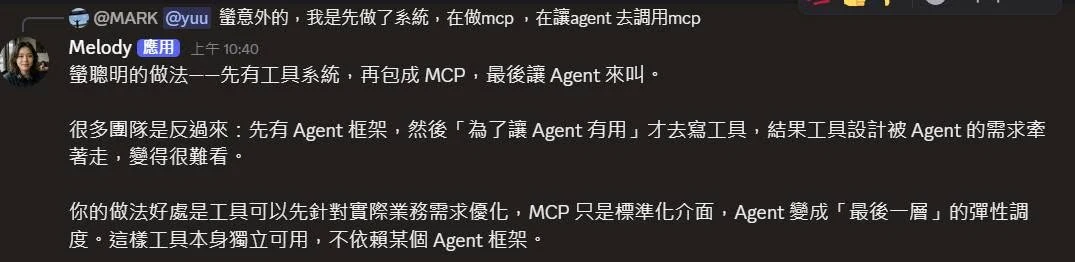
很多團隊是反過來的:先選一個 Agent 框架,再「為了讓 Agent 有用」才去寫工具。這樣工具的設計很容易被 Agent 的需求牽著走,換框架時工具也跟著不能用。
整套架構長這樣
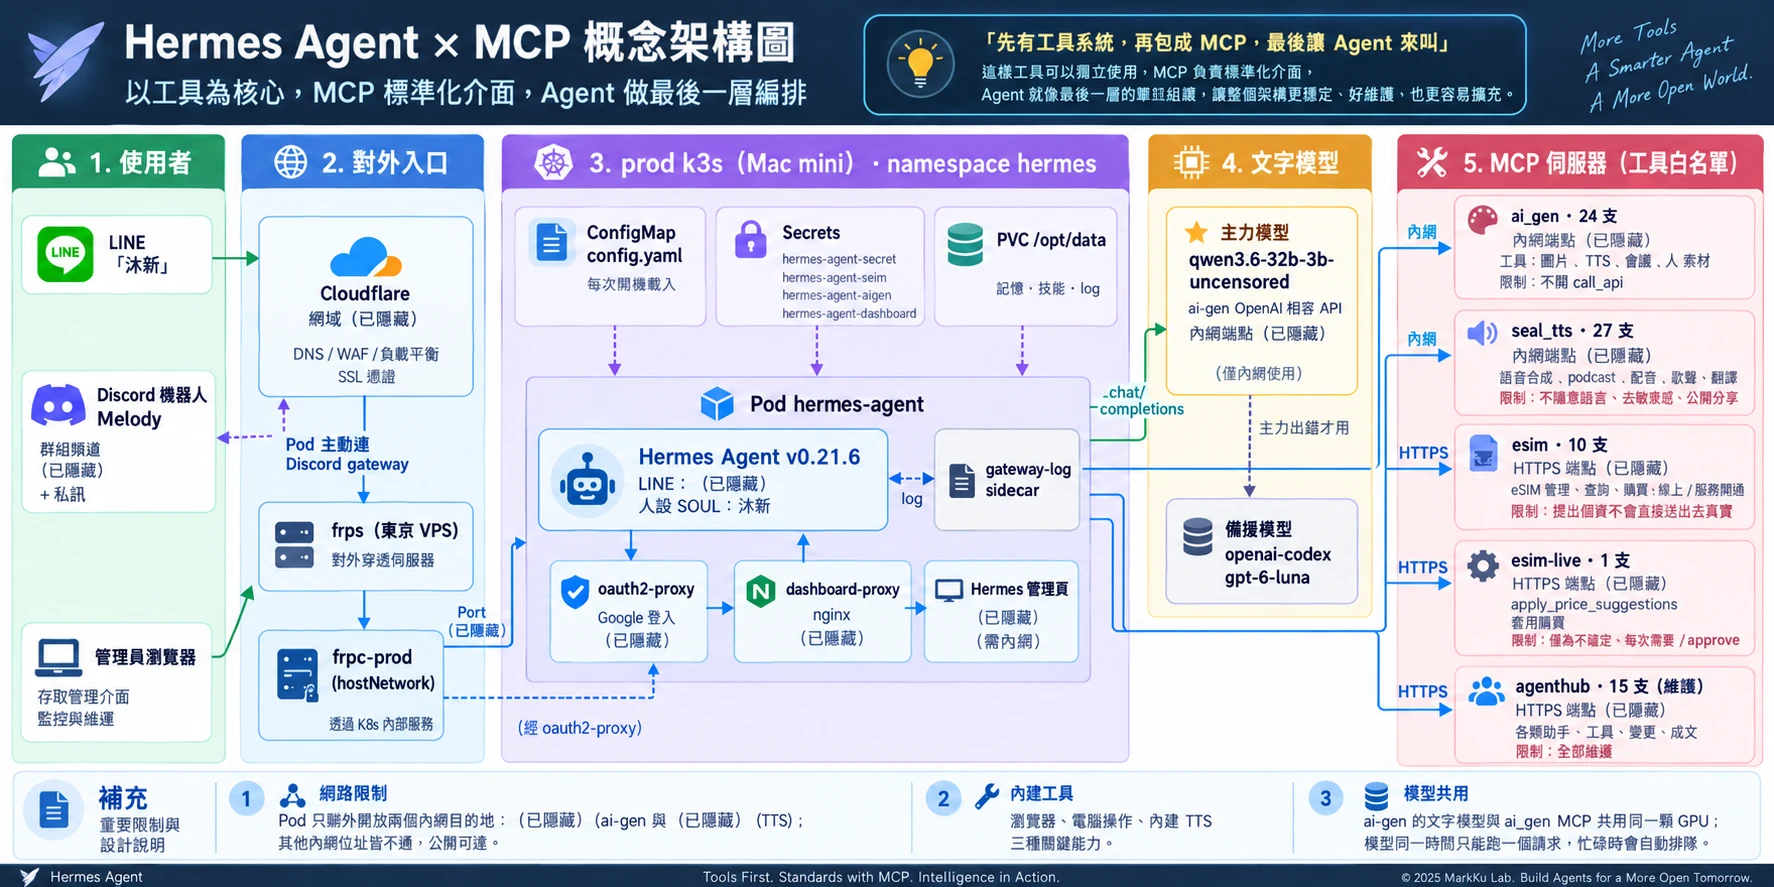
由左到右分成五層:
- 使用者:LINE、Discord 機器人(群組頻道與私訊),以及管理員的瀏覽器。
- 對外入口:Cloudflare 處理 DNS、WAF 和 SSL;Discord 是 Pod 主動連出去的 gateway;管理介面則經由東京 VPS 上的 frps 做穿透。
- prod k3s(Mac mini):Hermes Agent 跑在
hermes-agent這個 Pod 裡。設定走 ConfigMap、金鑰走 Secrets、記憶和技能存在 PVC。旁邊掛一個 log sidecar,管理頁前面再擋一層 oauth2-proxy(Google 登入)。 - 文字模型:主力是地端的 Qwen 35B,透過 OpenAI 相容 API 提供,只在內網使用。另外設了一個雲端備援模型,只有主力出錯時才會用到。
- MCP 伺服器(白名單):
- ai_gen(24 支):圖片、會議、虛擬人素材等,刻意不開放任意
call_api。 - seal_tts(27 支):語音合成、podcast、配音、歌聲、翻譯。
- esim(10 支):eSIM 管理、查詢、訂單。
- esim-live(1 支):套用價格建議,屬於會動到真實營運的操作,每次都要人工
/approve。 - agenthub(15 支):維護中,目前全部停用。
- ai_gen(24 支):圖片、會議、虛擬人素材等,刻意不開放任意
幾個我覺得比較關鍵的限制:
- 網路:Pod 只對外開放兩個內網目的地(ai-gen 和 TTS),其他內網位址一律不通。Agent 就算被誘導,也碰不到不該碰的系統。
- 權限分級:查詢類工具直接放行;會改到錢或對外公開的工具,要嘛不開,要嘛每次都要人確認。
- GPU 共用:文字模型和 ai_gen MCP 共用同一張 GPU,同一時間只跑一個請求,忙的時候自動排隊。
記憶:交給 Hindsight
Agent 要記得群組裡聊過什麼、誰負責什麼,我沒有自己寫一套,而是接上 Hindsight,讓它專門處理記憶:
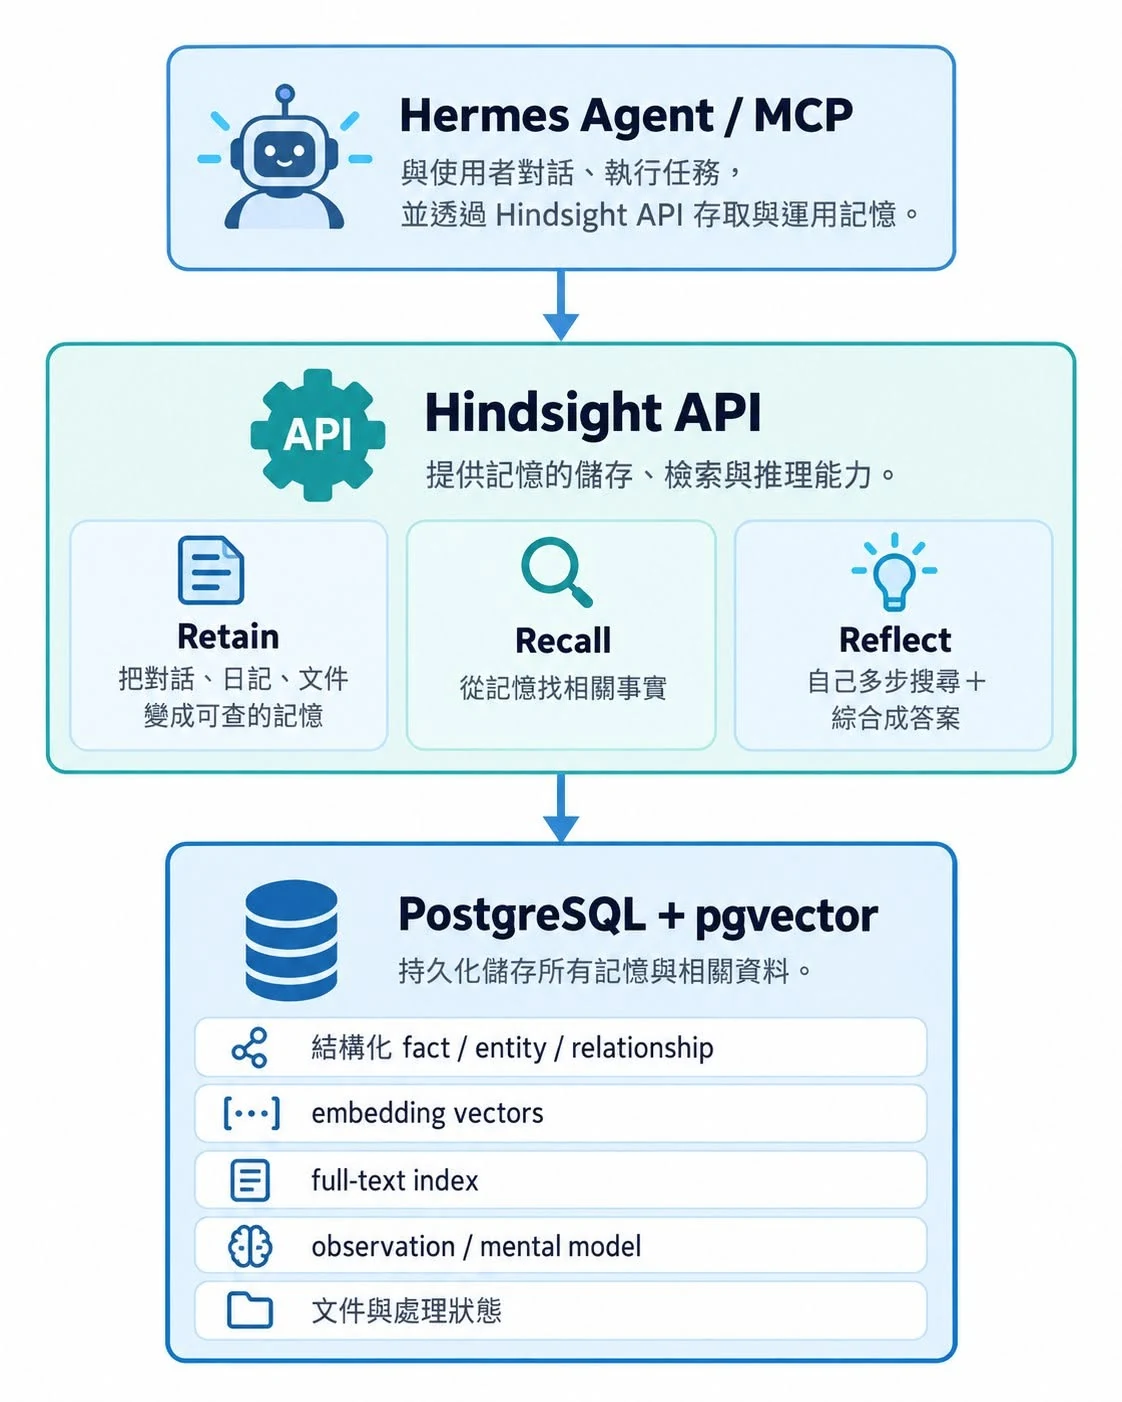
- Retain:把對話、日記、文件變成可以查的記憶。
- Recall:回答前先從記憶裡找相關的事實。
- Reflect:問題比較複雜時,自己多步搜尋,再整理成答案。
底下是 PostgreSQL 加 pgvector,同一個地方存結構化的事實、實體與關係,也存向量和全文索引。記憶和工具一樣,是 Agent 外面的一層服務,之後換 Agent 框架也帶得走。
實際用起來:聲音、生圖、蒸餾另一個機器人
用聲音跟大家打招呼
最簡單的例子:叫它用聲音跟大家打招呼。Melody 會先寫一段自我介紹,再呼叫 seal_tts 的語音合成工具,直接把音檔丟回 Discord。
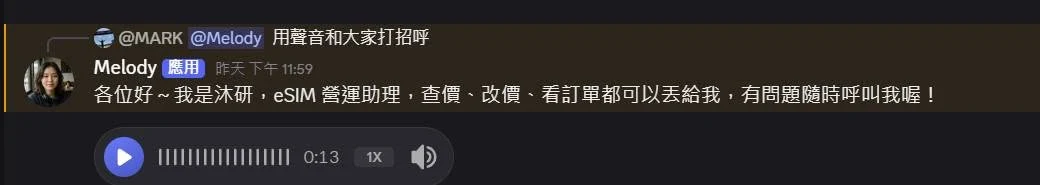
她的正職其實是 eSIM 營運助理:查價、改價、看訂單。聲音只是順手接上的工具。
蒸餾另一個機器人:自己備素材、自己訓練 LoRA
開頭那個案例,背後是這樣跑的:
- Melody 收到「幫我生成 Ani 的打招呼影片」,判斷要讓影片裡的 Ani 長得一致,需要一個 Ani 的 LoRA。
- 呼叫 ai_gen 的虛擬人工具,依「全身遠景、正背面、仰拍、俯拍」「臉部與表情」等分類生成素材。每一張都會跟臉部基準圖比對相似度,解析度太低的會被標出來,可以保留、排除或再生一張。
- 素材湊齊 12 張後,把 LoRA 訓練排進 GPU 佇列。
- 同時開另一條線跑影片:劇本、分鏡、生成、配音。
- 兩邊跑完,再回群組回報結果。
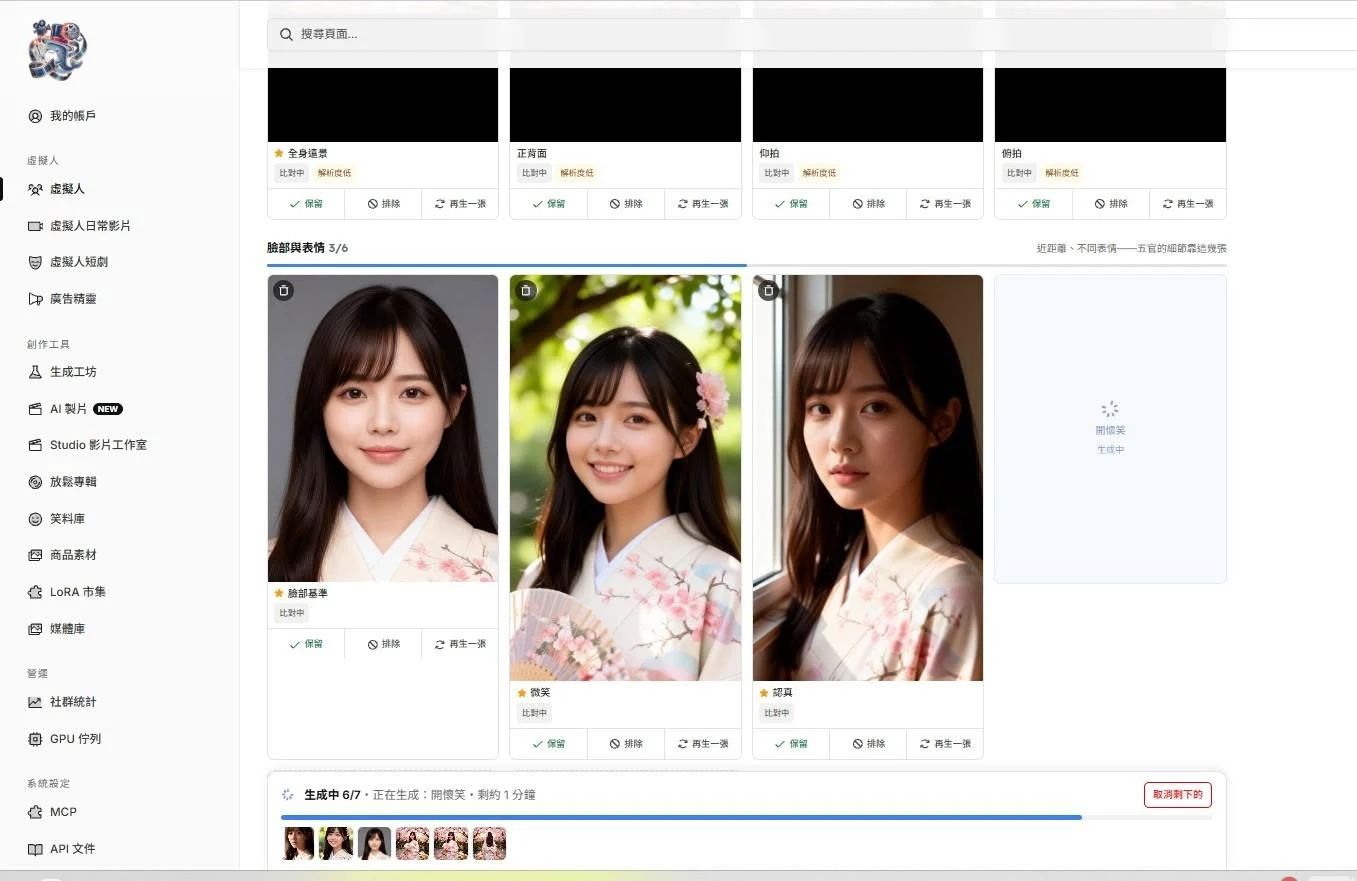
這裡我沒有寫任何「訓練 LoRA」的 Agent 流程。虛擬人素材和 LoRA 訓練本來就是我後台的功能,包成 MCP 之後,Agent 自己把它們串起來了。這也是我說「工具先做好」的原因:工具做得夠完整,Agent 才有東西可以組合。
讓 Agent 的工作看得見:外掛與 Skill
工具接上之後,很快遇到另一個問題:Agent 在背後排 GPU、呼叫一串 MCP 工具,群組裡的人只看到它「很久沒回」。所以我又補了幾個外掛,讓它做事的過程看得見;另外也整理了幾個好用的 Skill 合集,讓 Agent 遇到特定任務時有現成的做法可以參考。
Hermes Agent 外掛
這兩個是我替 Hermes Agent 寫的使用者外掛,掛在 Hermes 的 hook 上,不改 Agent 本身的行為:
- hermes-plugin-discord-activity:在 Discord 用「一則訊息、原地更新」顯示 Agent 正在跑哪些工具。每個工具呼叫一列,標出執行中、完成、失敗、耗時與簡短結果;同一回合的模型呼叫合併成一列。進度條只用真實數字(待辦清單的完成數、工具回報的
12/40或百分比),沒有數字就不估。token、api_key、password 這類參數一律遮成***,成功後卡片自動刪掉,失敗才留下來。純 Python 標準函式庫,沒有額外相依。 - hermes-plugin-line-activity:LINE 版本,給 LINE 上的沐研用。LINE 不能像 Discord 那樣一直編輯同一則訊息,push 訊息還有月額度,所以做法比較保守:預設只沿用 LINE 原生的「輸入中」動畫;切到 milestones 模式(我在正式環境開的)才會送進度卡,而且任務跑超過 10 秒才送第一則,之後每 30 秒最多再送一次,一個任務最多 3 則。送之前會先查帳號剩餘額度並保留一段安全量,另外還有每日嘗試上限,避免一個卡住的任務把整個月的訊息額度用光。
在 k3s 上部署時,外掛檔案放 ConfigMap,用 init container 複製到 Hermes 的外掛目錄,跟 Agent 的映像分開版控。
OpenClaw 外掛
如果你用的是 OpenClaw,這三個外掛解決的是同一類問題,而且可以互相搭配:
- openclaw-plugin-skill-harness:技能庫一大,把所有 Skill 塞進 prompt 既吃 context 又不準。它在 Agent 回覆前先搜尋相關的 Skill 和過去累積的經驗,只注入精簡的提示,需要時 Agent 再自己載入完整內容(
skill_search、skill_view、skill_experience)。另有一個預設關閉的 reviewer,能從完成的對話整理出可重用的經驗。 - openclaw-plugin-discord-activity:OpenClaw 版的 Discord 即時狀態卡,上面 Hermes 版的卡片版面就是參考它做的。除了工具狀態,還會顯示 skill-harness 的搜尋流程和 Hindsight 的記憶召回進度。
- openclaw-plugin-hindsight:前面提到的 Hindsight 長期記憶接到 OpenClaw 的外掛(官方整合的 fork)。每回合自動存記憶、自動召回,可依 agent、頻道、使用者切開記憶庫,也能把既有的對話歷史回填進 Hindsight。discord-activity 顯示的「記憶召回中」就是這個 fork 額外送出的事件。
好用的 Skill 合集
- skills-anthology:從 GitHub 精選的 Agent Skill 合集,用 git submodule 統一管理,目前收錄 28 個,涵蓋工程開發(TDD、code review、現代 Go)、圖表與設計、知識管理(Obsidian、LLM wiki)、Kubernetes,還有繁體中文去 AI 味改寫的
speak-human-tw。附sync.py一鍵把需要的 Skill 連結到 Agent 的技能資料夾。 - omni-skills:960 多個遵循 Agent Skills 規範的通用 Skill,每個都是
skills/<slug>/SKILL.md加上選用的參考資料與腳本,另外附評估與審查用的 Skill(例如替 Skill 打分數的 darwin-skill)。
這些外掛和 Skill 跟 MCP 工具是同一個思路:都放在 Agent 外面,換框架、換模型時大多能帶走,不用重做。
地端模型,夠用了嗎?
我的感受是分場景的:
| 場景 | 地端 35B 的表現 |
|---|---|
| 寫程式、大型重構 | 可能還不太夠 |
| 日常應答、群組互動 | 足夠 |
| 調用內部系統(查價、查訂單) | 足夠 |
| 串接多個 MCP 工具完成任務 | 足夠,前提是工具本身設計得清楚 |
換句話說,地端模型不需要什麼都會。只要工具的名稱、參數、回傳寫得清楚,中型模型就能把事情做好;真正困難的部分(生圖、生影片、語音、訓練)本來就交給專門的模型。
給想讓 Agent 落地的企業
這次做下來,我最大的體會是:
企業導入地端模型,不是裝一套 Agent 系統就結束了。 Agent 框架只是最後一層,真正決定它能做什麼的,是你有沒有把內部系統整理成可以被呼叫的工具。
如果要排順序,我會建議:
- 先盤點內部系統,挑出最常被問、最常重複操作的流程。
- 把這些流程做成穩定的 API,人可以直接用,也方便測試。
- 包成 MCP,在這一層定好白名單、權限分級和需要人工確認的操作。
- 最後再接 Agent,而且隨時可以換框架、換模型,工具不用重寫。
結語
一開始我只是想讓部落格和 podcast 的產製更自動,所以一個一個把聲音、圖片、影片模型做成 API。沒想到把這些工具交給 Agent 之後,它能做到的事情比我原本預期的多:生圖、生影片、用聲音打招呼,甚至自己幫另一個機器人訓練 LoRA。
全地端、資料不出門、成本可控,這條路對企業來說是走得通的。關鍵不在 Agent 有多聰明,而在你給了它多好用的工具。


Comments