

前言:Vibe Coding 的另一面
最近越來越多人在談 Vibe Coding,憑感覺寫 prompt、讓 AI 生成程式碼、快速拼湊出一個「能跑」的東西,乍看之下效率驚人,但以我的經驗來看,這種模式有時候容易忽略軟體工程中很核心的一個問題:可維護性。
軟體開發有個常被忽略的現實:真正的成本不在開發,而在維護。IEEE 的研究指出,軟體生命週期中有 60–80% 的成本發生在上線之後。「跑起來」只是起點,之後的 bug 修復、需求迭代、系統整合,才是真正耗時耗力的地方。
關於這個問題,業界已有不少觀察。Google Chrome 工程主管 Addy Osmani 說得很直接:Vibe Coding 和 AI 輔助工程是「根本不同的方法」。GitClear 分析了大量真實程式碼後也發現,AI 採用後複製貼上明顯增加、重構反而減少,最終形成一座座資訊孤島,程式碼品質看起來還行,但因為沒有人真正寫過、理解過,長期維護的負擔會越來越重。如果工程基礎不夠紮實,AI 的確可能在不知不覺中放大一些技術債。
這篇整理了六個我覺得值得投入的工程小技巧,分享給同樣在 Vibe Coding 浪潮裡摸索的你。
小技巧一:技術選型,先想清楚再動手
Vibe Coding 的節奏很快,有時候容易在「先跑起來再說」的心態下直接開工,等到後來才發現選的框架不適合當下場景,但對工具的特性有基本認識,確實能避免走一些不必要的彎路。 當然可以!以下是在不大幅修改內容的前提下,針對語意通順與排版進行優化的版本:
我的選型思路
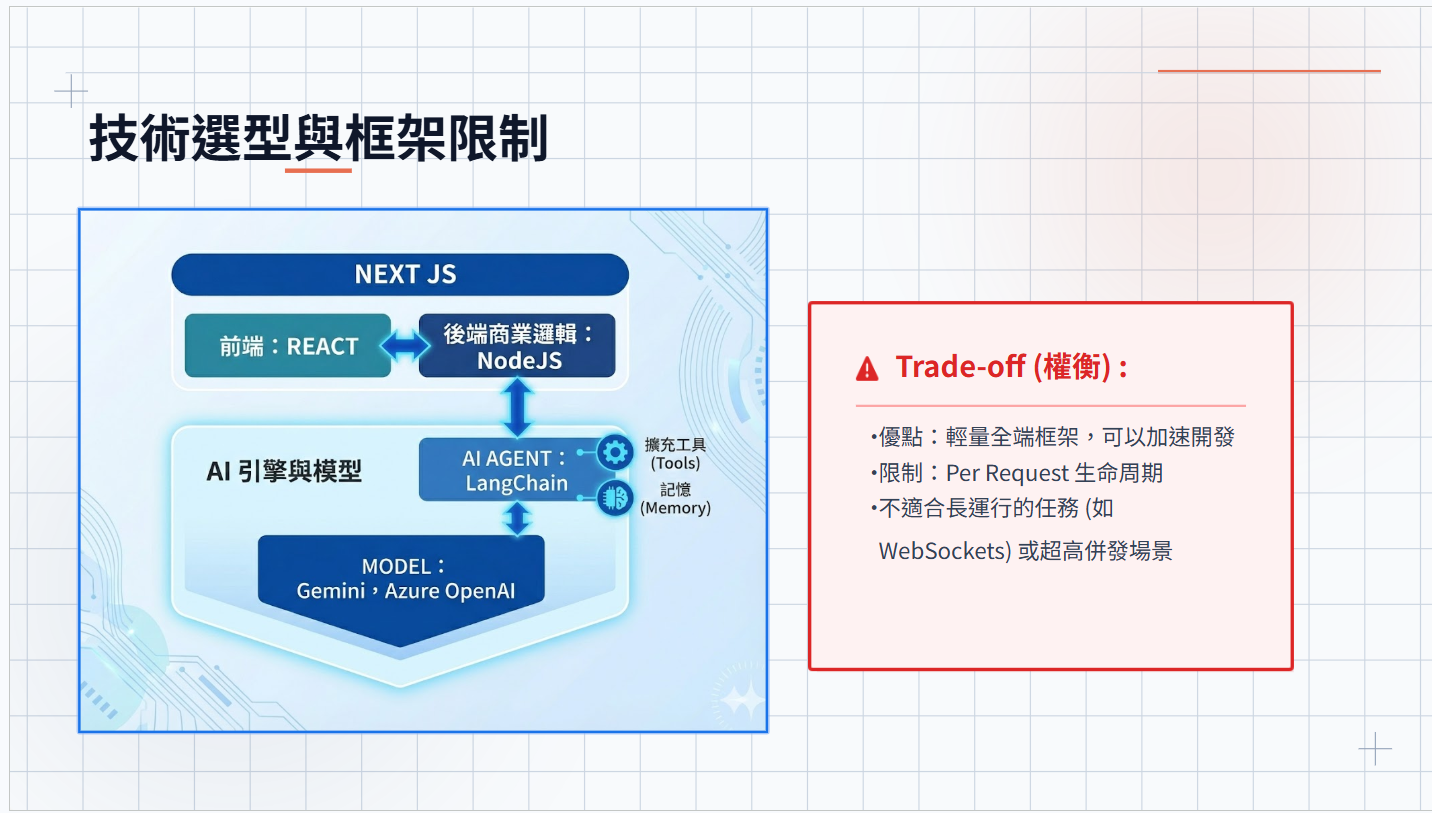
以我目前常用的全端框架:Next.js 為例
Next.js 本質上是 React 與 Node.js 的整合,因為腳本程式語言簡單,若前後端都在同一個專案中,這使得 AI 在協助開發時能夠縮小 Context,更容易聚焦於單一功能的實作,而 LangChain 也支援 Node.js 版本,使得開發 AI Agent 應用相當方便。
不過,它也有幾個特性需要留意:
單執行緒問題
Node.js 主要是單執行緒語言,預設只會使用一顆 CPU 執行。因此,當網站流量增加時,可能出現阻塞情況。此時可以透過 worker_threads 來解決。
常見場景:
- 高流量時 API 回應突然變慢
- 執行大量計算(如圖片處理、資料聚合、排名計算)時,整個 Event Loop 被阻塞,導致其他請求卡住
worker_threads 的核心概念是將 CPU 密集任務交由獨立執行緒處理,主執行緒則持續負責其他請求,待計算完成後再透過 parentPort.postMessage 回傳結果。
主執行緒(Event Loop)                 Worker Thread
         │                                   │
         │  new Worker('./heavy-worker.mjs') │
         │ ─────────────────────────────────▶│
         │                                   │
         │  繼續處理其他請求(不阻塞)        │  CPU 密集運算(獨立執行緒)
         │                                   │
         │◀─────────────────────────────────│
         │  postMessage({ result })          │
         │                                   │
不適合超高併發或持久連線
Next.js 的生命週期是 by-request,因此較不適合長連線服務、佇列、排程任務,例如 WebSocket、Queue、或排程任務(Cron Job)。
平行運算與後端技術選擇
在 Next.js 的 Server Side 中,可利用 Node.js 的 worker_threads 進行平行運算。針對複雜運算,小型專案基於共用性考量,我通常選擇使用 NestJS;而在大型專案中,則傾向採用 C# 來實作高效能且穩定的 API。
Node.js 數字運算:小數與大數
在處理金額、統計或加密等場景時,需要特別注意 JavaScript 的數值精度問題。可以透過精度數學函式庫解決,例如:decimal.js、big.js、bignumber.js。
善用 http-proxy-middleware 簡化架構
實務上常見為了解決 CORS 問題或隱藏後端 API 真實位址,而在 Next.js 中重複實作一層 API 轉發,增加了開發與維護成本。較為乾淨的做法是使用 http-proxy-middleware,讓 Next.js 的 API Route 純粹作為代理,將請求透明轉發至後端服務。
整體請求流程如下:
┌──────────────┐       /api/proxy/*        ┌──────────────────────┐
│              │ ─────────────────────────▶│  Next.js API Route   │
│   瀏覽器前端  │                           │    (proxyServer)     │
│              │ ◀─────────────────────────│                      │
└──────────────┘      回傳後端回應          └──────────┬───────────┘
                                                      │
                          pathRewrite:                │ 移除 /api/proxy 前綴
                          /api/proxy/users → /users   │
                                                      ▼
                                           ┌──────────────────────┐
                                           │     後端 API 服務     │
                                           │   (NEXT_PUBLIC_API)  │
                                           └──────────────────────┘
代理過程中會自動處理:
- relayRequestHeaders — 轉發 Cookie(含 Turnstile bypass token)
- relayResponseHeaders — 攔截
Set-Cookie並進行額外處理 - onError — 記錄代理失敗的錯誤 Log
useEffect 的副作用
React 的 useEffect 若管理不當,容易產生重複的 API 請求,在快速開發時特別容易踩到此問題。
Prefetch 預設開啟
<Link> 元件預設會在列表頁面 prefetch 所有連結,當列表很長時,可能帶來大量背景 Request,需依實際場景評估是否關閉。
多語系(i18n)支援容易
Next.js App Router 搭配 next-intl,多語系設定門檻低。語系檔以 JSON 維護,透過 middleware 自動偵測語系並重導向,元件中使用 useTranslations() 取得字串,整體架構清晰,無需額外複雜設定即可支援多國語言。
前端狀態管理的選擇
- 小型專案:使用
useState並透過 props 傳遞即可。 - 中型專案:當元件層級加深、出現 props drilling 時,推薦使用 Zustand,其 API 極簡、幾乎沒有 boilerplate,學習成本低。
- 大型專案:若需要嚴格的
action/reducer分離與 middleware 機制,可採用 Redux Toolkit,雖然已大幅減少樣板程式碼,但整體複雜度仍高於 Zustand。
使用 TanStack Query 管理 Server State
Client state 是可完全掌控的,但 Server state 僅是後端資料的快照,source of truth 仍在伺服器端。實務上,每個 API 呼叫都需處理 loading、error、retry、timeout 等流程,並面臨快取與跨元件同步的問題,例如:
- API 資料是否需要快取?
- 使用者切頁後是否需要重新請求?
- 是否需要背景 polling 以保持資料新鮮?
- 在 A 頁面 mutate 資料後,B 頁面如何同步更新?
過去這些邏輯常分散在 useEffect 與 useState 中,導致重複開發。TanStack Query 將整個請求生命週期(發送、快取、重試、失效、同步)轉為宣告式設定,只需定義 staleTime 與 refetch 條件,其餘交由框架處理。
再搭配統一的 API 回應格式(success + error.code),即可在 QueryClient 層實作全域錯誤攔截,例如:
AUTH-001:自動導向登入頁面RATE-001:顯示限流提示
如此一來,無需在每支 API 中重複撰寫 try-catch,大幅提升開發效率與一致性。
AI Agent 框架:LangChain / LangGraph
LangChain 可以想成沒有畫面的 n8n:讓工程師透過程式碼快速串接各種 AI 模型和外部工具,用同一套介面在 OpenAI、Gemini、Claude 之間自由切換,不被單一廠商綁死。內建的 Memory、Tool Calling、RAG 等模組,讓常見的 AI 應用場景不用從零開始刻。
LangGraph 則是 LangChain 生態系中專門用來處理多狀態、有條件分支的 Agent 流程。當 AI 任務不是一路線性跑到底,而是需要根據中間結果決定下一步,比如「先判斷文章品質,品質不足就重新生成,通過才繼續產出音訊」,這種有分支、有回退的工作流,用 LangGraph 來建模會清楚很多。
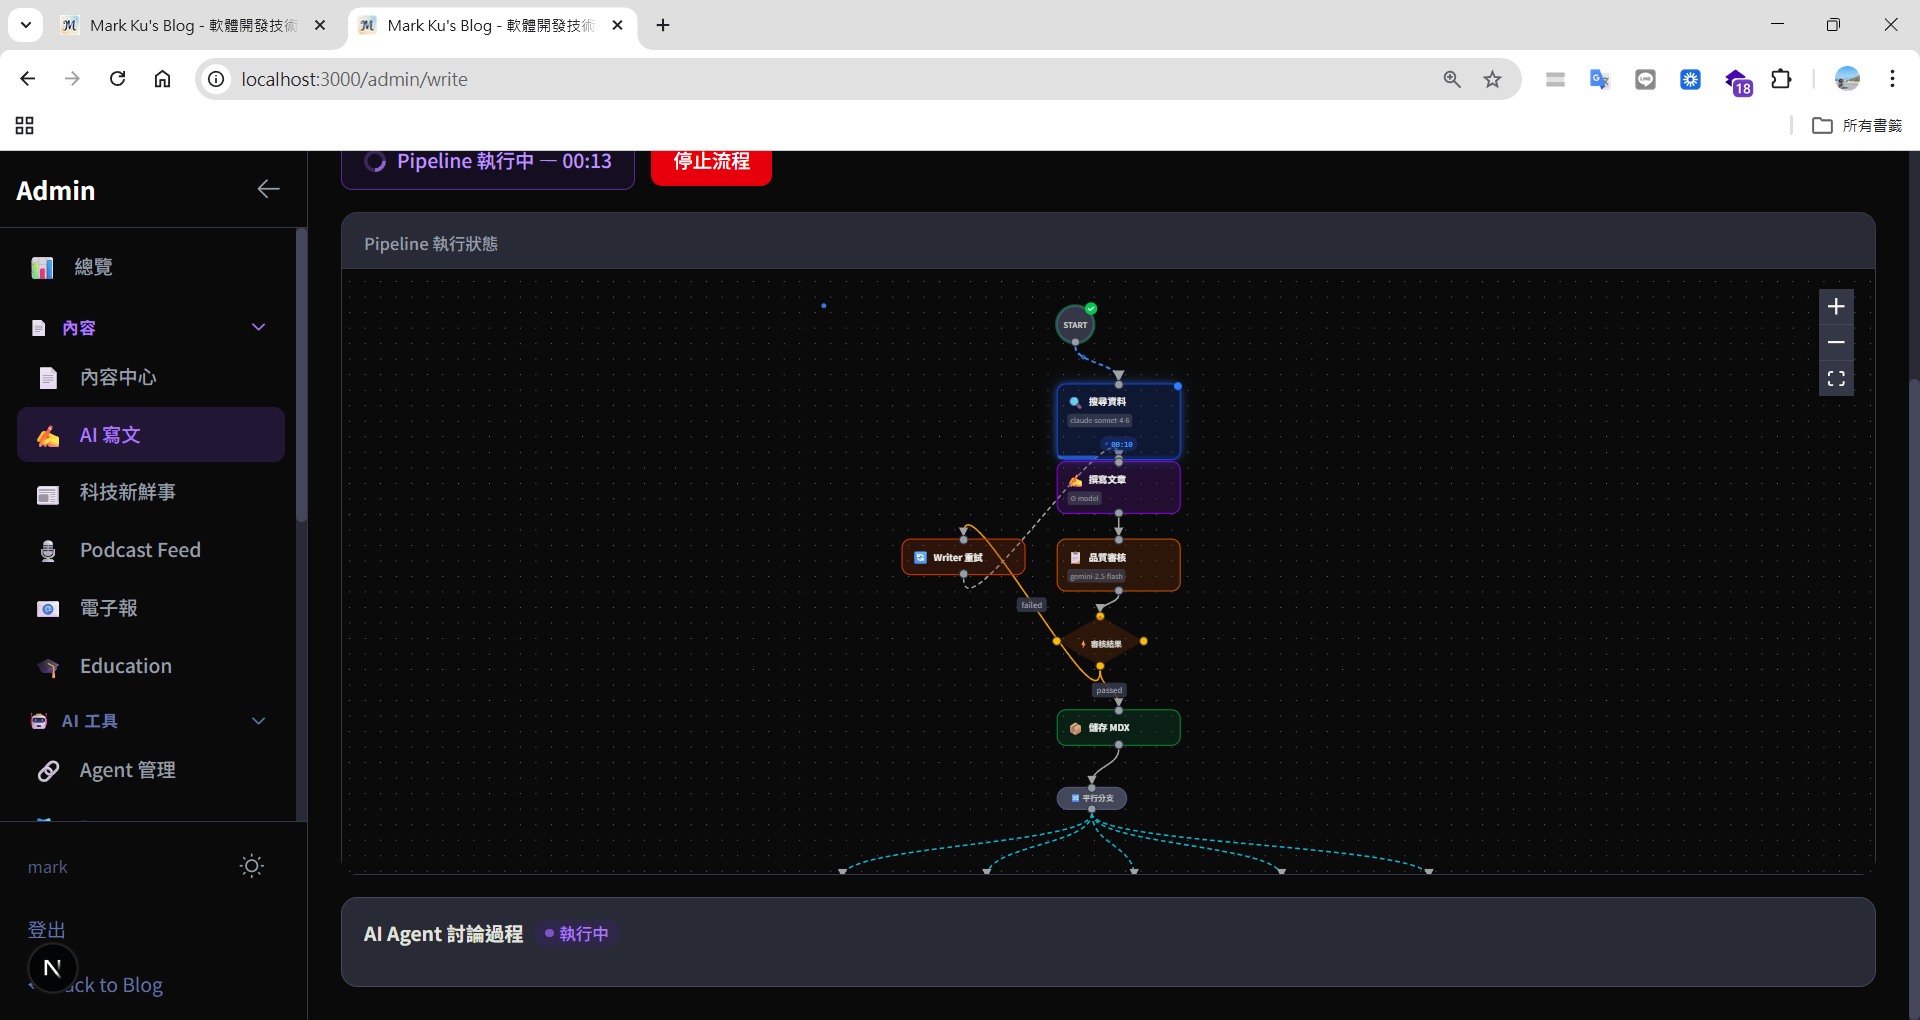
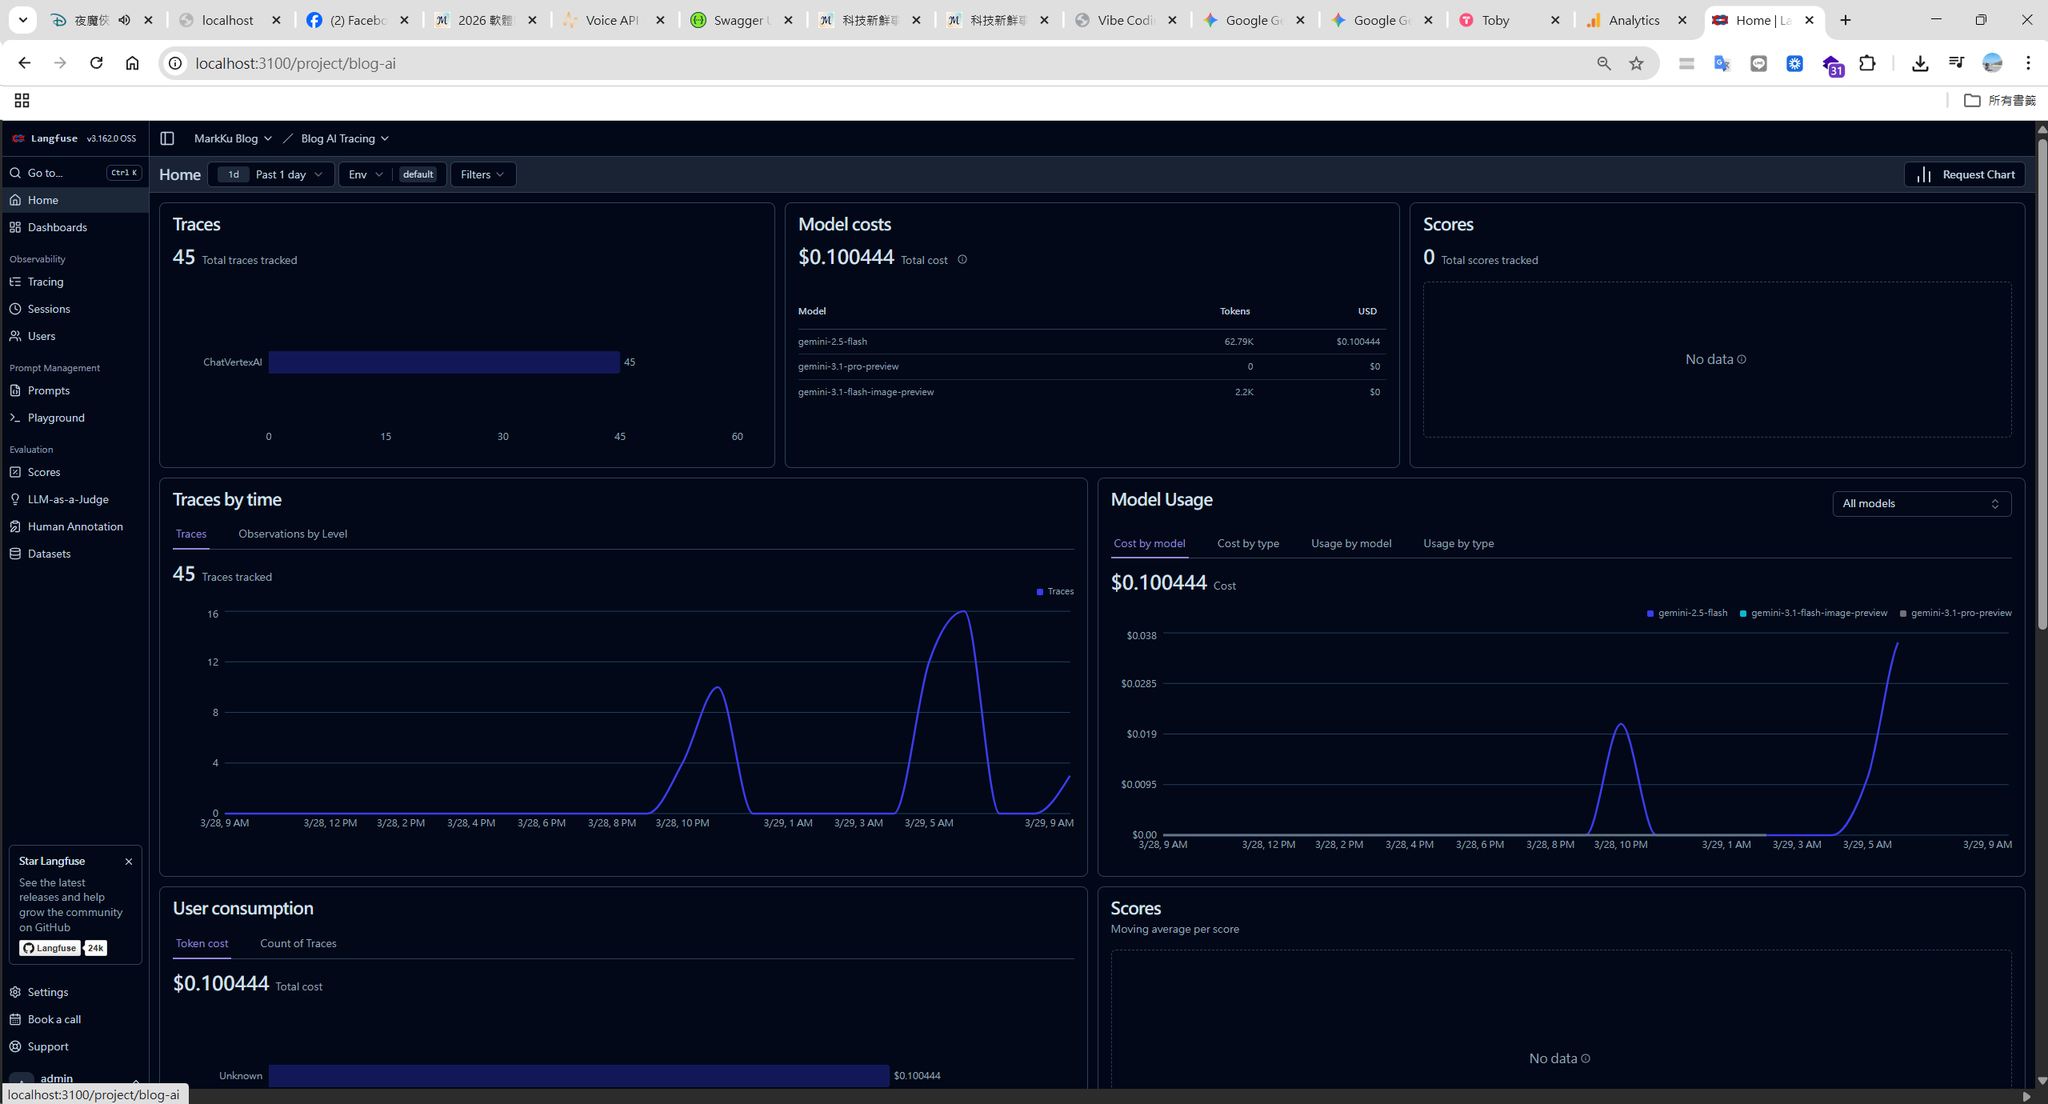
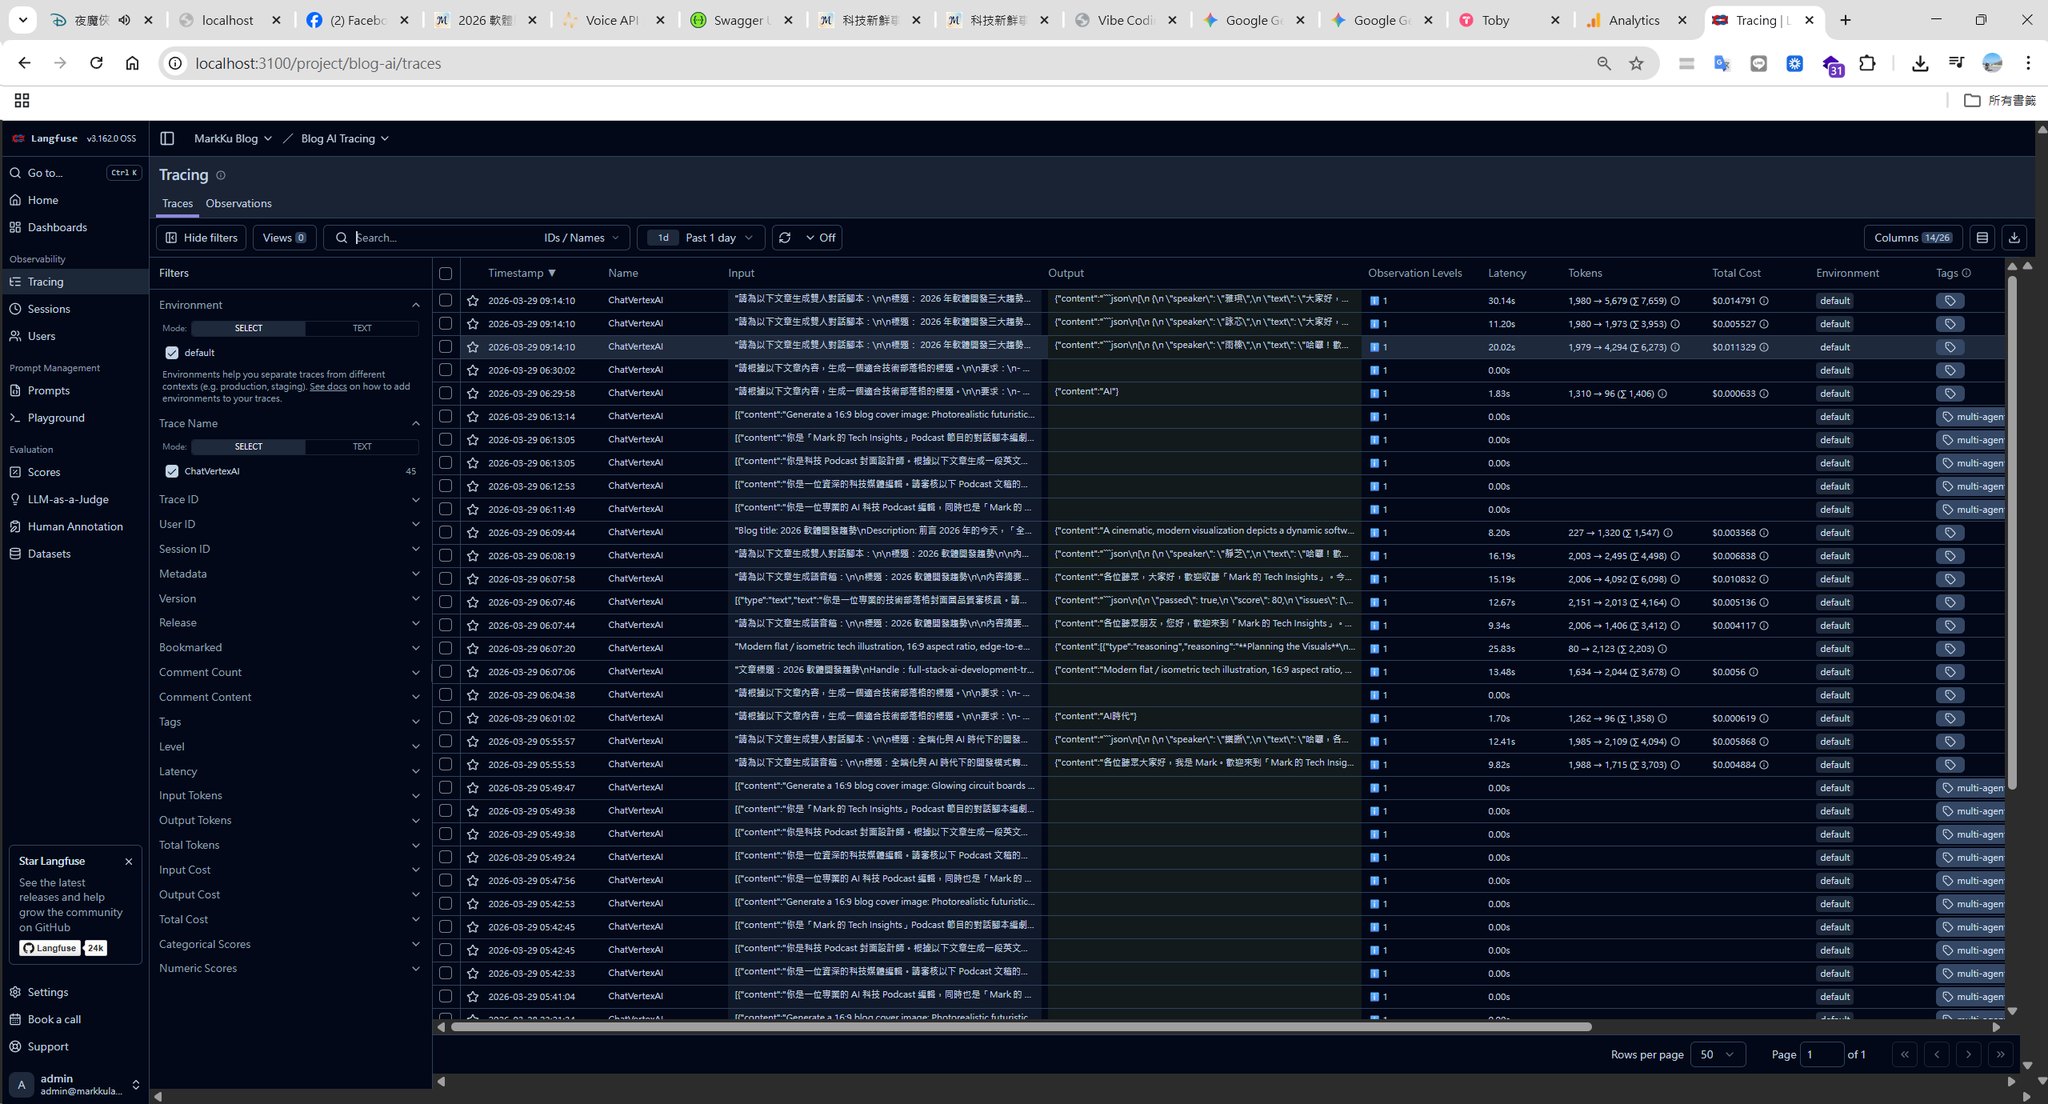
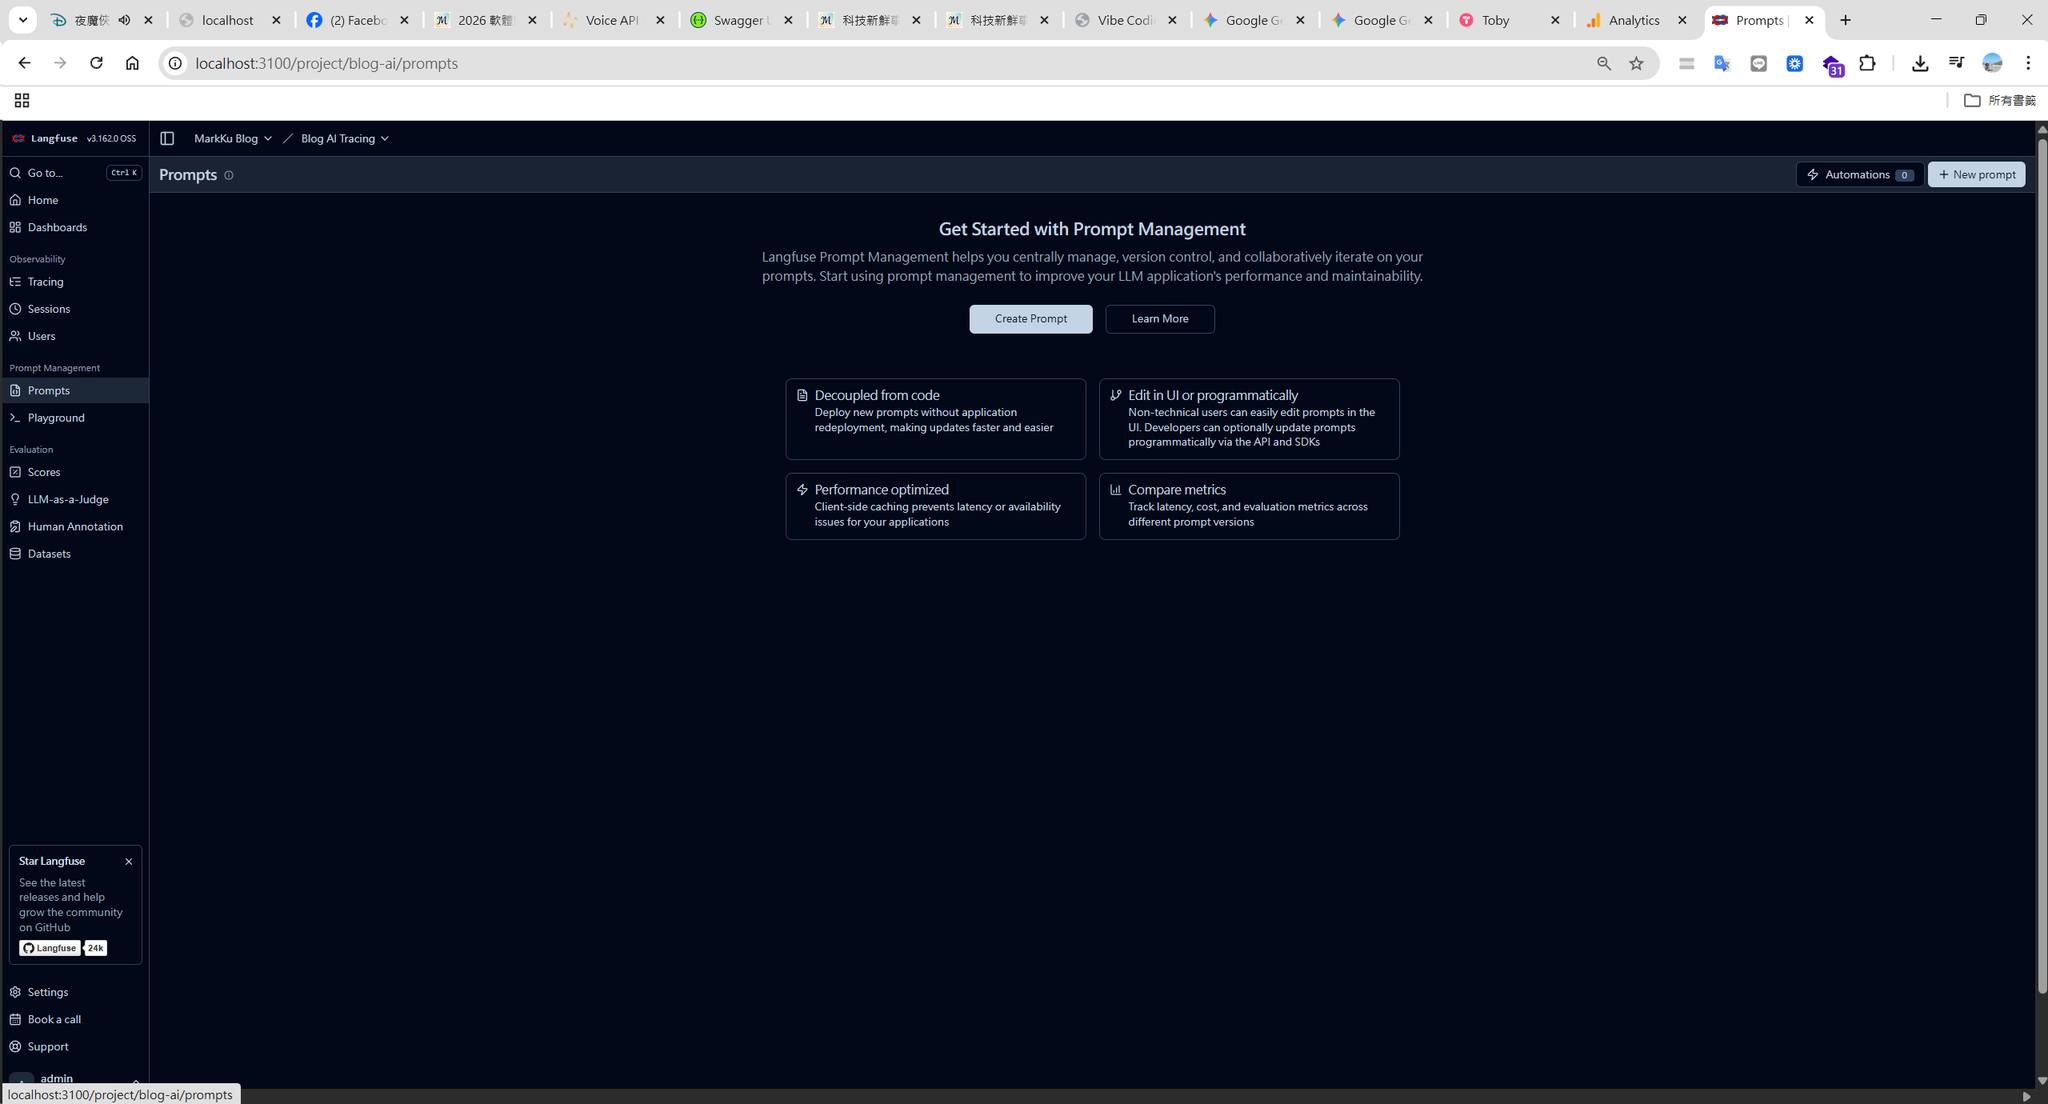
搭配 Langfuse 可以做 AI 可觀測性(Observability),記錄每次呼叫的 prompt、回應、Token 用量、延遲,方便追蹤哪個環節花費最多、哪個 prompt 品質不穩,對於要持續優化 AI 行為的產品來說相當實用。
樣式框架:Tailwind CSS
Tailwind CSS 採用 Mobile First 的設計哲學,預設 selector 從手機尺寸出發,再透過 md:、lg: 等前綴往上覆蓋桌機樣式,跟傳統「桌機優先再往下 override」的思維相反,但在響應式開發上反而更直覺。
搭配它豐富的 utility helper,很多過去需要手刻 SCSS 的常見排版、間距、陰影,直接用 class 就能搞定,省下不少設計時間。
另外我通常會在國外平台買一套 Next.js + Tailwind 的 UI theme 當起點來開發,在整成自己想要的風格,這樣既有現成的元件可以用,開發也比較快速,日後如果要換框架或重構樣式,因為 utility class 本身耦合度低,遷移起來也相對容易
資料庫:我個人傾向 PostgreSQL
MongoDB 的靈活確實很吸引人,不用寫 Migration、Schema 隨時改、早期開發很快,但我自己用下來,Schema 沒約束這件事長期反而是個麻煩,資料品質很難保證,$lookup 又遠不如 SQL JOIN 好用。另外沒設好索引很容易觸發全表掃描(COLLSCAN),在 MongoDB Atlas 這類雲端服務上,除了直接噴掉讀取單位費用,還會撐爆記憶體,逼得系統自動升級到更貴的規格,帳單可能會飆得很快。
所以我大多數情況還是選 PostgreSQL,完整 ACID、原生 JOIN、工具鏈(Prisma / Drizzle)成熟,jsonb 欄位需要彈性結構時也能用。對我來說,在 PostgreSQL 裡補彈性比在 MongoDB 裡補關聯查詢容易多了。
MongoDB 我覺得比較適合:資料結構天生是 JSON 且沒什麼關聯(如日誌、CMS 設定)、或需要超大規模水平擴展的場景,長期要維護的產品,我還是傾向 PostgreSQL。
語言:TypeScript 是維護性的基礎
這個我覺得不太需要說服,用過就知道。TypeScript 的型別系統在 AI 大量生成程式碼的情境下更明顯有價值,型別錯了 IDE 直接紅線,不用等到 runtime 才爆,AI 也比較不容易生出「傳錯參數但 JavaScript 不報錯」這種靜默 bug。
對長期維護影響最大的是重構時,你改了某個介面,TypeScript 馬上告訴你哪些地方要跟著改,而不是靠人工記憶或跑測試才發現漏了。搭配 Prisma / Drizzle 的型別推導,連資料庫查詢的型別都有保障,整條鏈路都是型別安全的。
資料夾配置與 Helper / Service 分層
AI 傾向將邏輯就近放置於最近編輯的檔案,隨著時間推移,容易導致元件夾帶 API 邏輯、工具函式散落各處,使得修改單一功能時需同時調整多個位置。因此,應將此開發規範更新至 Claude.md(專案操作手冊),以提升 AI 產出的一致性與可維護性。
我通常在 Next.js 專案裡這樣拆層:
data/:純資料存取(讀檔案、打 API、查 DB)services/:業務邏輯(跨資料源的組合與規則判斷)lib/:有一定規模的工具模組(可獨立測試)utils/:無副作用的純函式小工具(日期、數字格式化)hooks/:React 專屬的自訂 Hookcomponents/:純 UI,不含業務邏輯app/api/:只做請求接收與回應格式化
這樣分層後,跟 AI 協作時也更容易說清楚要改哪一層,減少 AI 亂改到不相干的地方。
小技巧二:統一 API 回應格式,讓錯誤有跡可循
API 格式不統一是我遇過最常見的維護痛點之一。常見的情況是用 HTTP 200 包裝所有回應,錯誤只回傳一段 message: "Something went wrong",出了問題根本不知道從哪查起。服務數量一多,這種混亂只會越來越難收拾。
我的做法
我參考 RFC 9457(一份描述 HTTP API 錯誤格式的業界標準),設計了統一的 API 回應結構,成功和失敗都有固定欄位:
// ✅ 成功回應
{
  "success": true,
  "data": {
    "userId": "u-20260410",
    "name": "Mark Ku"
  }
}

// ❌ 錯誤回應
{
  "success": false,
  "error": {
    "type": "https://api.example.com/errors/auth",
    "code": "AUTH-001",
    "message": "Token 已過期,請重新登入",
    "traceId": "req-7f3a-4b2c-9d1e"
  }
}
幾個我覺得比較實用的設計:
-
錯誤碼加領域前綴:
AUTH-001(認證)、IDM-4001(身份管理)、ORD-2003(訂單),一眼就知道問題出在哪個服務 -
traceId 貫穿全鏈路:從 API Gateway 到後端服務用同一個 traceId,跨服務除錯不再像大海撈針
-
HTTP Status Code 如實反映:401 就是 401,不要再用 200 包裝錯誤
效益
API 行為變得可預測,前端可以用統一的錯誤處理邏輯。出錯時,拿著 AUTH-001 和 traceId 就能快速定位問題。
小技巧三:用 Keycloak 打造穩固的身份認證基石
Vibe Coding 的特性是快速生成、快速驗證,但副作用之一是容易產生大量各自獨立的小系統,每個 side project 或微服務都是一個全新的開始。系統數量一多,整合就成了最大的痛點,每個服務各有一套登入機制,用戶體驗碎片化,維護成本也急速上升。
身份認證是系統安全的第一道防線,以我的經驗,自行開發登入模組不僅複雜、耗時,更容易在「感覺差不多」的心態下埋入安全漏洞。常見的情境是:每個服務各自實作一套認證邏輯,Token 驗證方式不統一、Session 管理散落各處,出了問題很難追查。
實際怎麼導入
Keycloak 是 Red Hat 旗下的開源身份管理平台(IAM),支援 OAuth2、OpenID Connect,可以做為整個系統的認證中心,讓各服務不用各自實作登入邏輯。我的做法是用它集中管理所有服務的認證與授權:
-
社群登入:透過 Identity Brokering 功能,快速整合 Google、GitHub、Facebook、Line 等第三方登入,建議啟用 matching email 自動帳號連結
-
多租戶隔離:Keycloak 26+ 已支援 Organization 功能,為 SaaS 產品建立獨立的登入環境
-
安全強化:啟用 MFA(多因素認證)、嚴格驗證 Redirect URL、開啟登入事件監控
整體互動流程如下:
┌──────────┐     ①  登入請求      ┌──────────────┐
│          │ ──────────────────▶  │              │
│  前端 App │                      │   Keycloak   │
│          │ ◀──────────────────  │   (IdP Hub)  │
└──────────┘     ⑤  JWT Token     └──────┬───────┘
                                         │
                              ②  Identity │ Brokering
                                         │
                                         ▼
                                  ┌──────────────┐
                                  │  第三方 IdP   │
                                  │  Google /     │
                                  │  GitHub /     │
                                  │  Facebook     │
                                  └──────┬───────┘
                                         │
                                  ③  OAuth2 授權  │
                                  ④  回傳用戶資訊 │
                                         ▼
                                   (回到 Keycloak
                                    發行 JWT Token)
效益
認證集中到 Keycloak 之後,各服務只需驗證 JWT Token,不用再各自造輪子。出問題時也有登入事件監控可以查,比過去各自為政好追多了。
小技巧四:讓 AI 成為你的重構及測試夥伴,而非債務產生器
直接把程式碼丟給 AI 說「幫我重構」,有時候效果不如預期。GitClear 的數據顯示,AI 採用後程式碼重構行為反而減少了不少。Qodo 的調查也指出,很多開發者反映重構時 AI 缺少足夠的上下文,容易產生看似合理但實際上破壞既有行為的修改。
問題不在 AI 不夠聰明,而在於我們給它的指引不夠精確。
實際怎麼跟 AI 協作
核心概念是:先補測試,再交給 AI 重構,最後跑測試確認沒有回歸。讓 AI 在有安全網的範圍內工作,而不是讓它自由發揮。
第一步,先為既有程式碼補測試(確保行為有被覆蓋):
// 假設有一個計算折扣的函式,邏輯有點亂但「能跑」
// 重構前,先確保測試覆蓋其行為

describe('calculateDiscount', () => {
  it('VIP 會員打 8 折', () => {
    expect(calculateDiscount(1000, 'vip')).toBe(800)
  })
  it('一般會員無折扣', () => {
    expect(calculateDiscount(1000, 'regular')).toBe(1000)
  })
  it('金額為 0 時回傳 0', () => {
    expect(calculateDiscount(0, 'vip')).toBe(0)
  })
})
第二步,小範圍請 AI 重構,人工審查:
// 重構前
function calculateDiscount(amount: number, type: string): number {
  if (type === 'vip') {
    return amount * 0.8
  } else if (type === 'svip') {
    return amount * 0.7
  }
  return amount
}

// AI 重構後 — 人類審查確認邏輯不變,可讀性提升
const DISCOUNT_RATE: Record<string, number> = {
  vip: 0.8,
  svip: 0.7,
}

function calculateDiscount(amount: number, type: string): number {
  const rate = DISCOUNT_RATE[type] ?? 1
  return amount * rate
}
效益
這樣能避免改完才發現行為偷偷跑掉。重點不是不用 AI,而是把測試當安全網,讓 AI 在這個範圍內發揮。
小技巧五:AI 生成的程式碼,別忘了資安掃描
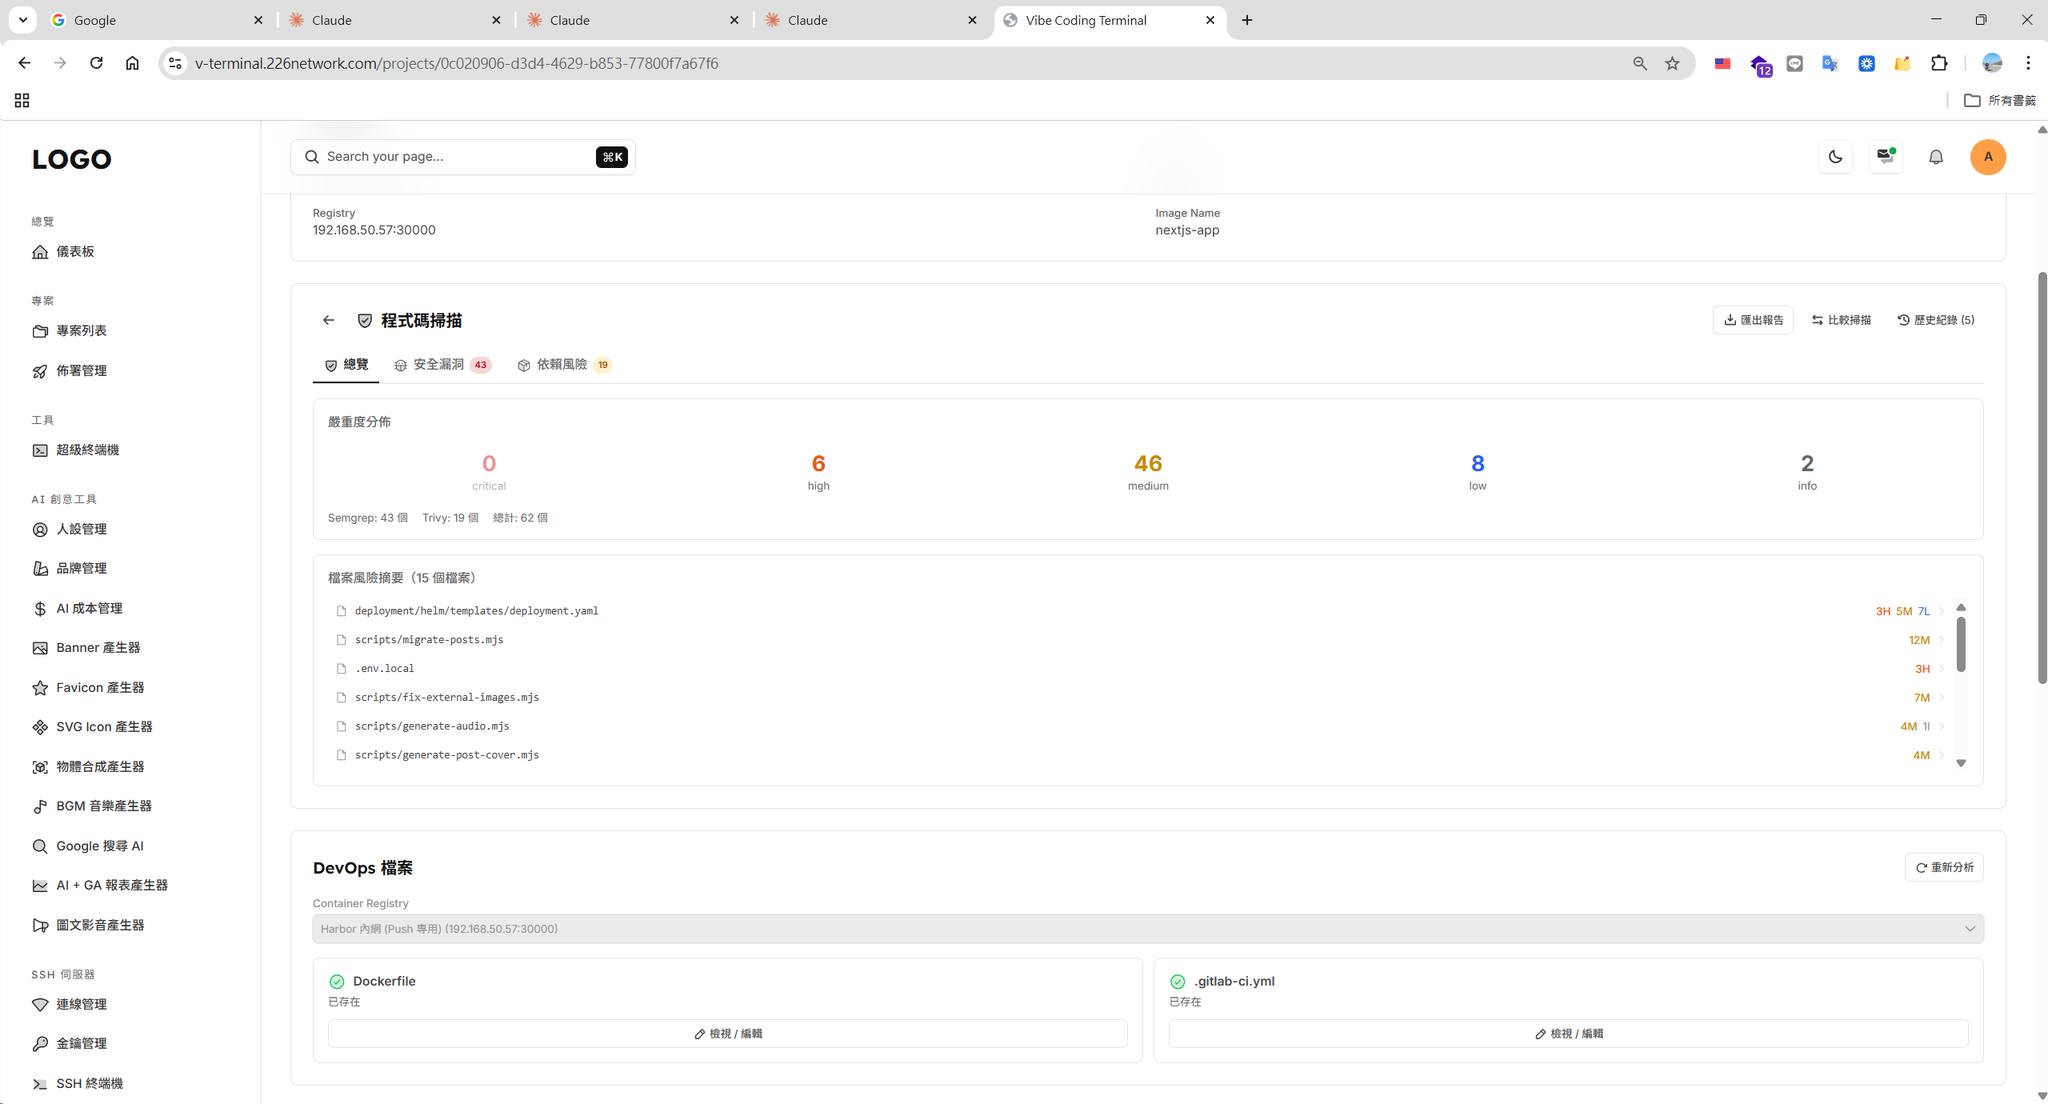
AI 生成的程式碼有時候量很大,靠人工逐行 review 安全問題其實來不及,以我自己的經驗,AI 有時候會生成看起來沒問題但實際上有潛在風險的程式碼,像是直接拼字串組 SQL、把 secret 硬寫進程式、或是開了太寬鬆的 CORS 設定,這些如果沒有掃描機制,在 code review 時很容易漏掉。
實際怎麼掃
目前我主要用兩個方式來補這個缺口:
1. 用 Claude Skill 做 code review
直接請 Claude 針對生成的程式碼做資安角度的審查,找出潛在的 SQL Injection、XSS、Hardcoded Secret、權限漏洞等問題,比讓人工盯著看省力很多。
2. 整合開源 CLI 進 CI/CD Pipeline
把資安掃描工具接進 pipeline,讓每次 PR 或 push 自動跑,常見的選擇有:
| 工具 | 用途 |
|---|---|
Semgrep | 靜態分析,支援多語言,規則可自訂 |
Trivy | 掃描 container image、dependency 漏洞 |
Gitleaks | 偵測是否有 secret / token 不小心進了 repo |
npm audit / pnpm audit | 檢查 npm 套件的已知安全漏洞 |
掃描接進 pipeline 之後,每次 PR 都會自動跑一輪,不用靠人工記得。
效益
AI 生成的量越大,資安漏洞被忽略的機率就越高。把掃描自動化之後,這件事就不再依賴人工的細心程度,出問題前就能被擋下來。
小技巧六:為API訂閱打下基礎,導入 API Gateway(Kong),實現關注點分離,
AI 時代,打造自己的 SaaS 變得容易,但以我的經驗,沒有工程基礎,光靠 Vibe Coding 很難撐過複雜度的門檻。功能越疊越多,改 A 壞 B,認證、限流、日誌各自為政,重複的邏輯散落各處,出了問題也不知道從哪查起。
這正是我之前在 Kong API Gateway 架構驗證 中碰到的痛點,但每個服務各自實作一套,看起來都能跑,但維護起來很吃力。
導入方式
API Gateway 是一個位於所有後端服務前面的統一入口,把認證、限流、日誌等共用邏輯集中處理,讓每個後端服務只需專注自己的業務邏輯。Kong 是目前最成熟的開源選項之一。
整體架構如下:
                         ┌─────────────────────────────────┐
                         │        Kong API Gateway          │
                         │                                  │
  ┌──────────┐           │  ┌───────────┐  ┌────────────┐  │    ┌──────────────┐
  │          │  Request   │  │   JWT     │  │   Rate     │  │    │ User Service │
  │  Client  │ ────────▶ │  │ 認證驗證  │─▶│  Limiting  │──│──▶ │              │
  │          │           │  └───────────┘  └────────────┘  │    └──────────────┘
  └──────────┘           │         │              │         │
                         │         ▼              ▼         │    ┌──────────────┐
                         │  ┌───────────┐  ┌────────────┐  │    │ Order Service │
                         │  │  Logging  │  │  Request   │──│──▶ │              │
                         │  │  統一日誌 │  │ Transform  │  │    └──────────────┘
                         │  └───────────┘  └────────────┘  │
                         │                                  │    ┌──────────────┐
                         │                                 ─│──▶ │ Payment Svc  │
                         │                                  │    └──────────────┘
                         └─────────────────────────────────┘
效益
後端服務能專注於核心業務邏輯,不用再各自造輪子,所有流量政策集中管理,新服務上線時只需在 Kong 設定路由和 Plugin 就好,省了很多重複工作。
結論
Vibe Coding 的問題不在於用了 AI,而在於有時候容易跳過工程思維。軟體真正在解決的是複雜性,梳理需求、設計邊界、討論取捨,這些過程 AI 目前還沒辦法替代。
這六個方向都不是什麼新發明,它們在 AI 出現之前就存在,只是在 Vibe Coding 盛行的當下,反而更值得再想一次。選型想清楚、回應格式統一、認證集中管、重構有測試保護、資安自動掃、流量統一入口,每一個拿出來都不難,但疊在一起,就是讓 AI 幫你放大能力,而不是放大負擔的差距。


留言