
前言
我手上同時跑著好幾個會呼叫 AI 的專案:部落格產文與 podcast、股票小工具、eSIM 方案比對,再加上平常寫程式用的 Agent。以前每個專案各自串供應商:Claude 寫文章、NVIDIA 免費模型補量、OpenAI 出圖、區網的 Ollama 跑地端模型。結果就是三個老問題:
- 金鑰散落:每個專案的
.env都放著一份供應商金鑰,換一把要改好幾個地方。 - 成本看不清:月底才知道哪個專案燒最多錢。
- 單點故障:NVIDIA 額度用完、Claude 回 429,整條流程就停下來,得手動改程式換模型。
所以我自架了一台 LiteLLM Proxy(v1.108),當作個人的地端 AI API Gateway,對外是 https://litellm.markkulab.net。所有應用都只打這一個 OpenAI 相容入口,由 Gateway 決定實際送去哪個模型、額度不夠時往下降級、順便把用量和花費記下來,上游金鑰也只放在它身上。
選 LiteLLM 的理由很實際:
- OpenAI 相容:應用端只要換
base_url和金鑰,程式幾乎不用改。 - 雲端、地端一視同仁:Anthropic、NVIDIA、OpenAI、Ollama、自架服務都是
model_list裡的一列。 - 治理功能內建:Virtual Key、預算、限速、Fallback、用量儀表板,裝好就有,還有一套 Admin UI 可以直接在網頁上改。
整體架構
一個請求進來,依序經過三層:
- Virtual Key 驗證:這把 key 能用哪些模型、還剩多少預算、每分鐘能打幾次。
- Router:把應用指定的模型名稱(通常是用途別名)對到實際的部署。
- Fallback 鏈:主模型失敗就照順序換下一個,雲端都不行就落到地端。
每一次呼叫的 token、花費、延遲、成功與否,都寫進 PostgreSQL,Admin UI 的儀表板就是從這裡算出來的。
一、整合雲端與地端模型
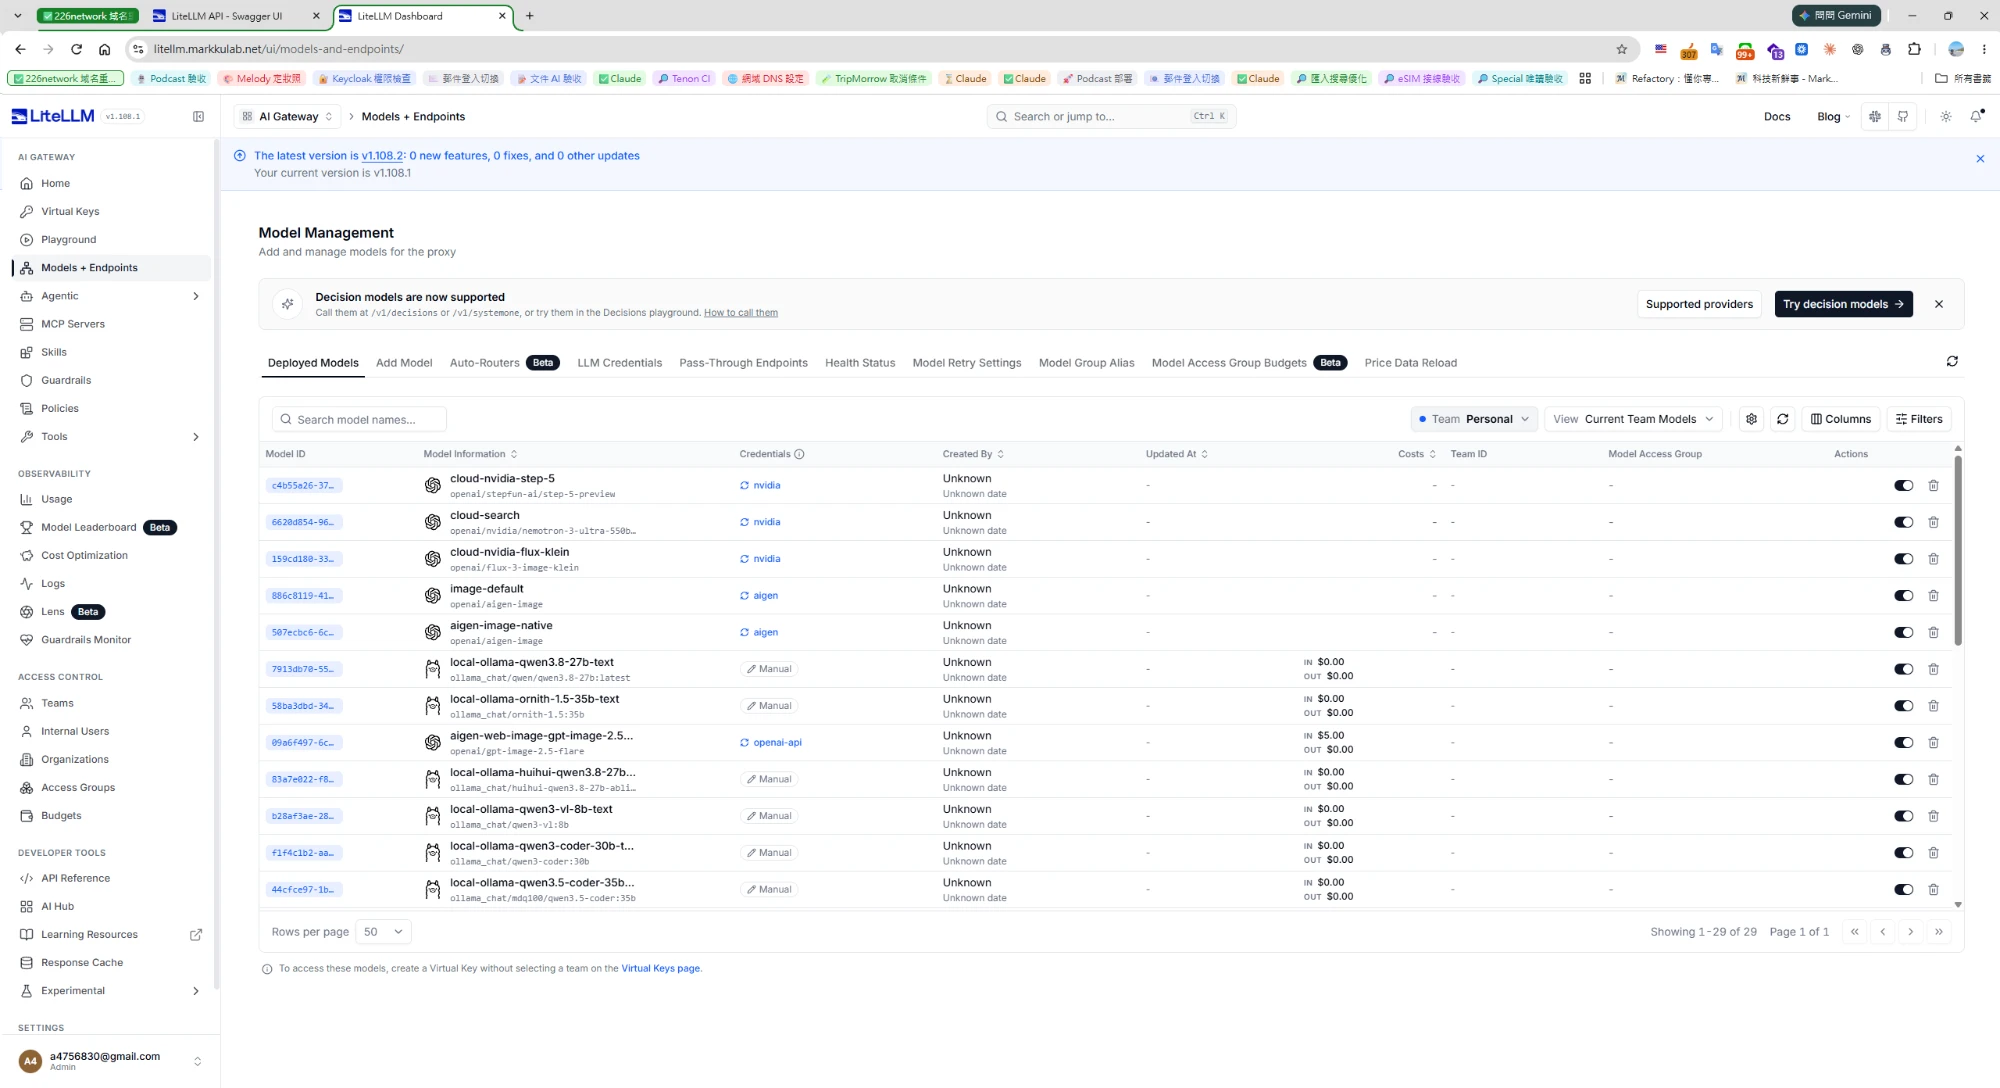
目前 Gateway 上註冊了 29 個模型,來源大致分四類:
| 來源 | 例子 | 憑證 |
|---|---|---|
| 雲端 Claude | cloud-claude、cloud-claude-sonnet、cloud-claude-haiku | Anthropic |
| NVIDIA 免費模型 | cloud-nvidia-mistral-large、cloud-nvidia-glm-flash、cloud-nvidia-step-5、cloud-nvidia-nemotron-ultra、cloud-nvidia-nemotron-super-vl、cloud-nvidia-flux-klein(出圖) | nvidia |
| 雲端出圖 | cloud-openai-image、aigen-web-image-gpt-image-2.5-flare | openai-api |
| 地端 | Ollama 的 local-ollama-qwen3.8-27b-text、local-ollama-ornith-1.5-35b-text、local-ollama-qwen3-coder-30b-text、local-ollama-qwen3.5-coder-35b-text、local-ollama-qwen3-vl-8b-text;自架出圖 image-default、aigen-image-native | aigen/Manual |
命名我刻意加上 cloud- 和 local- 前綴,看 Logs 或排行榜時,一眼就知道這筆是付錢的還是地端的。
截圖裡的 Credentials 欄位也值得注意:NVIDIA 模型都指向同一組 nvidia 憑證,ai-gen 指向 aigen,地端 Ollama 不需要金鑰所以顯示 Manual。上游金鑰只存在 Gateway,模型只是「引用」它,這點在下面的金鑰管理會再展開。
config.yaml 範例
我平常大多在 Admin UI 上加模型,但用 YAML 表達比較好看懂。下面是縮減過的範例(金鑰一律從環境變數讀):
# 可重複使用的上游憑證:模型只寫名字,不重複貼金鑰
credential_list:
  - credential_name: nvidia
    credential_values:
      api_key: os.environ/NVIDIA_API_KEY
      api_base: https://integrate.api.nvidia.com/v1

model_list:
  # 雲端 Claude
  - model_name: cloud-claude
    litellm_params:
      model: anthropic/claude-sonnet-5        # 換成你要用的版本
      api_key: os.environ/ANTHROPIC_API_KEY

  # NVIDIA 免費模型:走 OpenAI 相容格式,引用 nvidia 憑證
  - model_name: cloud-nvidia-step-5
    litellm_params:
      model: openai/stepfun-ai/step-5-preview
      litellm_credential_name: nvidia

  # 地端 Ollama:單價明確設 0,儀表板才不會把它算進花費
  - model_name: local-ollama-qwen3.8-27b-text
    litellm_params:
      model: ollama_chat/qwen/qwen3.8-27b:latest
      api_base: http://<ollama-host>:11434
      input_cost_per_token: 0
      output_cost_per_token: 0
ollama_chat/ 前綴會走 Ollama 的 /api/chat,對多輪對話和工具呼叫的支援比 ollama/ 好,地端聊天模型建議用這個。
二、用途別名:應用端只說「我要做什麼」
應用程式不寫死模型名稱,只呼叫幾個用途別名:
| 用途別名 | 用途 |
|---|---|
text-default | 一般文字生成、摘要、翻譯 |
search-default | 需要上網查資料的任務 |
vision-default | 看圖、OCR |
image-default | 文字生圖 |
tts-default | 語音合成 |
部落格這邊的做法是:環境變數沒指定模型時,一律退回這些別名,由 Gateway 決定實際模型與降級順序。要換模型、調順序、加一台地端主機,都只動 Gateway,應用端不用重新部署。
import os
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["LITELLM_BASE_URL"],   # 例如 https://litellm.markkulab.net/v1
    api_key=os.environ["LITELLM_API_KEY"],     # 這是 Virtual Key,不是供應商金鑰
)

resp = client.chat.completions.create(
    model="text-default",                     # 只說用途,不指定廠牌
    messages=[{"role": "user", "content": "幫我把這段整理成三點摘要"}],
)
print(resp.choices[0].message.content)
三、容錯移轉:額度用完自動降級
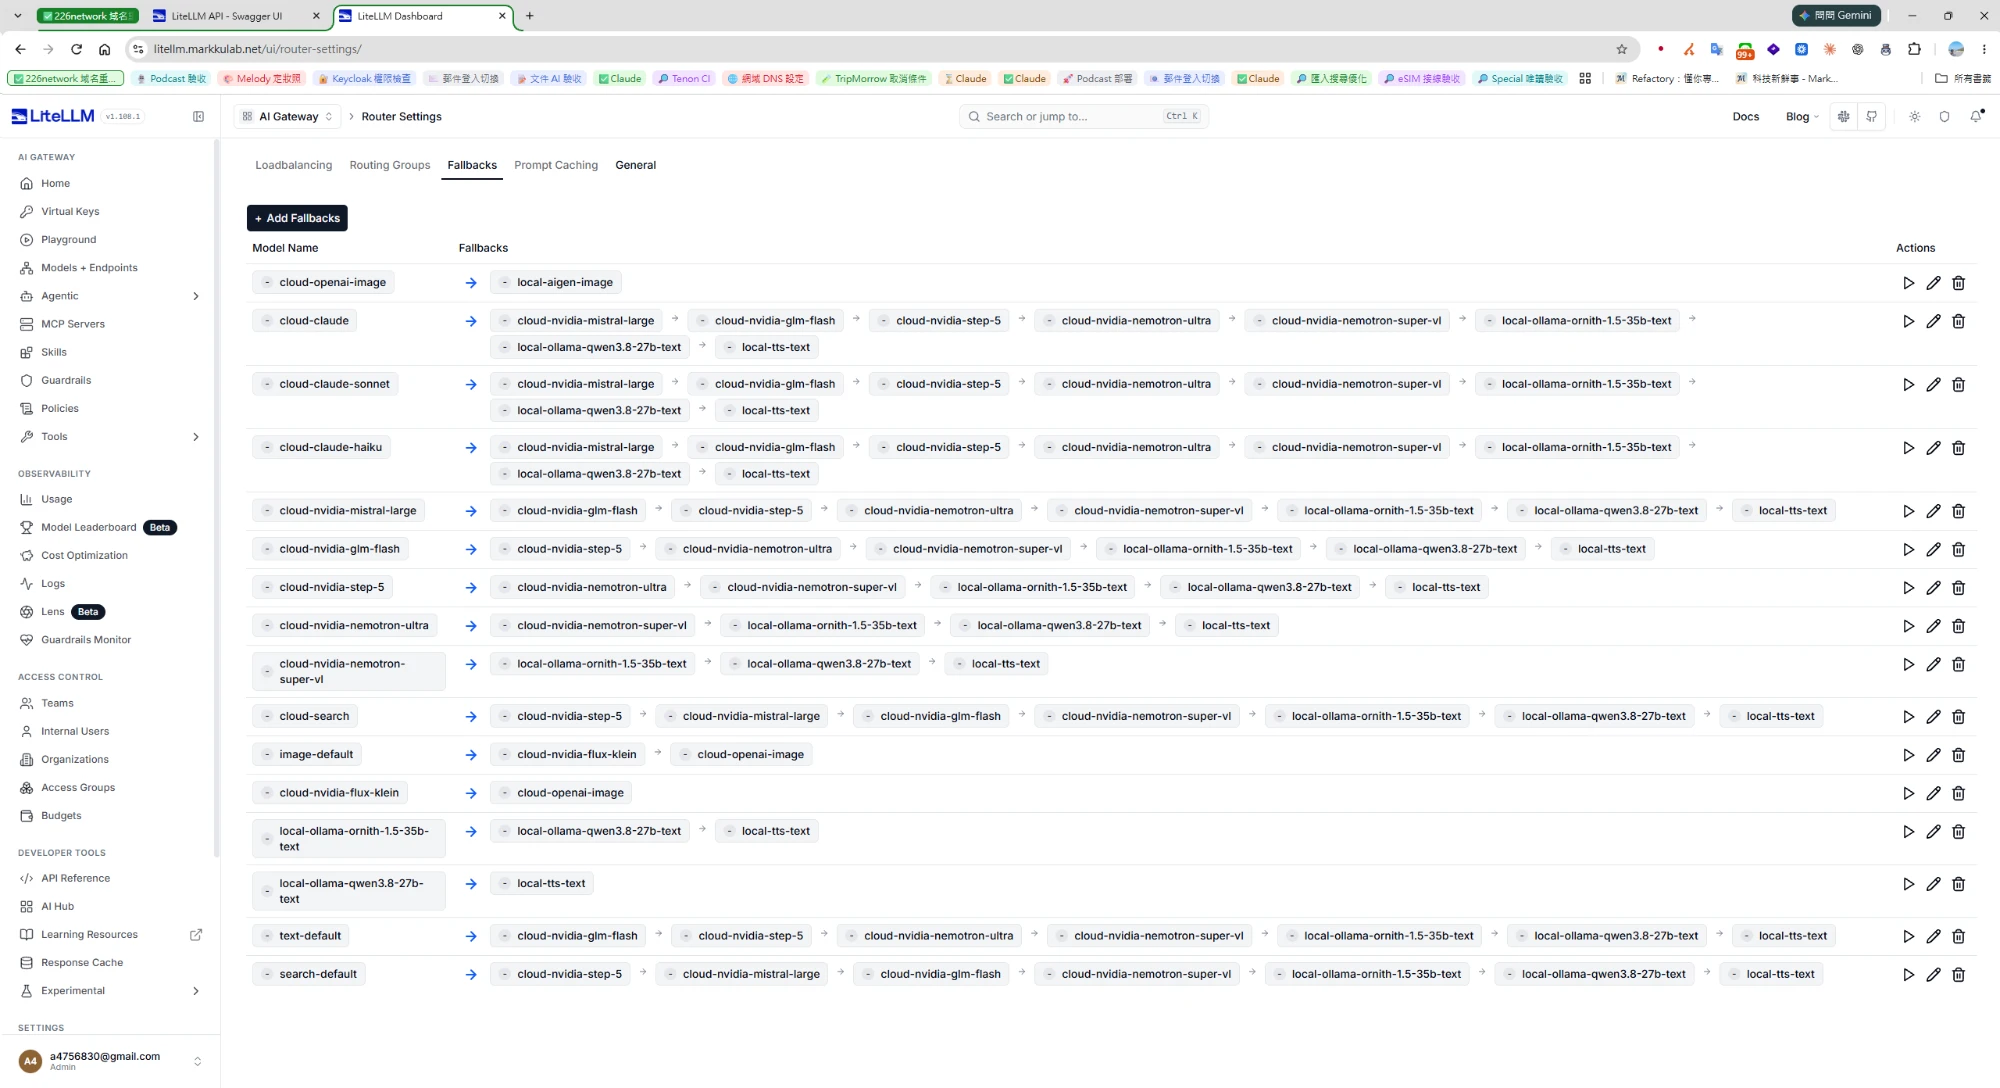
這是整套架構最有價值的部分。在 Router Settings 的 Fallbacks 分頁,每個模型都掛了自己的降級順序。以 cloud-claude 為例:
原則是 付費雲端 → 免費雲端 → 地端兜底:
- 付費模型在最前面,品質最好。
- NVIDIA 免費模型接著上,它們有速率限制,常回 429,但一個不行就換下一個,整體可用度還是很高。
- 地端放最後,速度慢一點,但不會因為額度用完而失敗。
其他鏈也是同樣的思路:
| 模型 | 降級順序 |
|---|---|
text-default | glm-flash → step-5 → nemotron-ultra → nemotron-super-vl → 地端 ornith → 地端 qwen3.8 → local-tts-text |
search-default | step-5 → mistral-large → glm-flash → nemotron-super-vl → 地端 ornith → 地端 qwen3.8 → local-tts-text |
image-default | NVIDIA flux-klein → cloud-openai-image |
cloud-openai-image | 地端 ai-gen 出圖 |
出圖這條是兩段式:image-default 失敗會換 NVIDIA 的 flux-klein,再不行換 OpenAI;而 cloud-openai-image 自己又掛了地端 ai-gen 當最後防線。
用 YAML 表達大概長這樣:
router_settings:
  num_retries: 2          # 同一個模型先重試幾次
  allowed_fails: 3        # 一分鐘內失敗幾次就先冷卻
  cooldown_time: 60       # 冷卻秒數,期間直接跳過這個部署
  max_fallbacks: 10       # 預設只會往下試 5 個,鏈長的話要調大
  fallbacks:
    - cloud-claude:
        - cloud-nvidia-mistral-large
        - cloud-nvidia-glm-flash
        - cloud-nvidia-step-5
        - cloud-nvidia-nemotron-ultra
        - cloud-nvidia-nemotron-super-vl
        - local-ollama-ornith-1.5-35b-text
        - local-ollama-qwen3.8-27b-text
        - local-tts-text
在 Admin UI 的 Fallbacks 分頁,每一列右邊有一個 ▶ 按鈕可以直接測試整條鏈,改完順序先按一下,比上線後才發現斷鏈好得多。
四、用量統計與費用計算
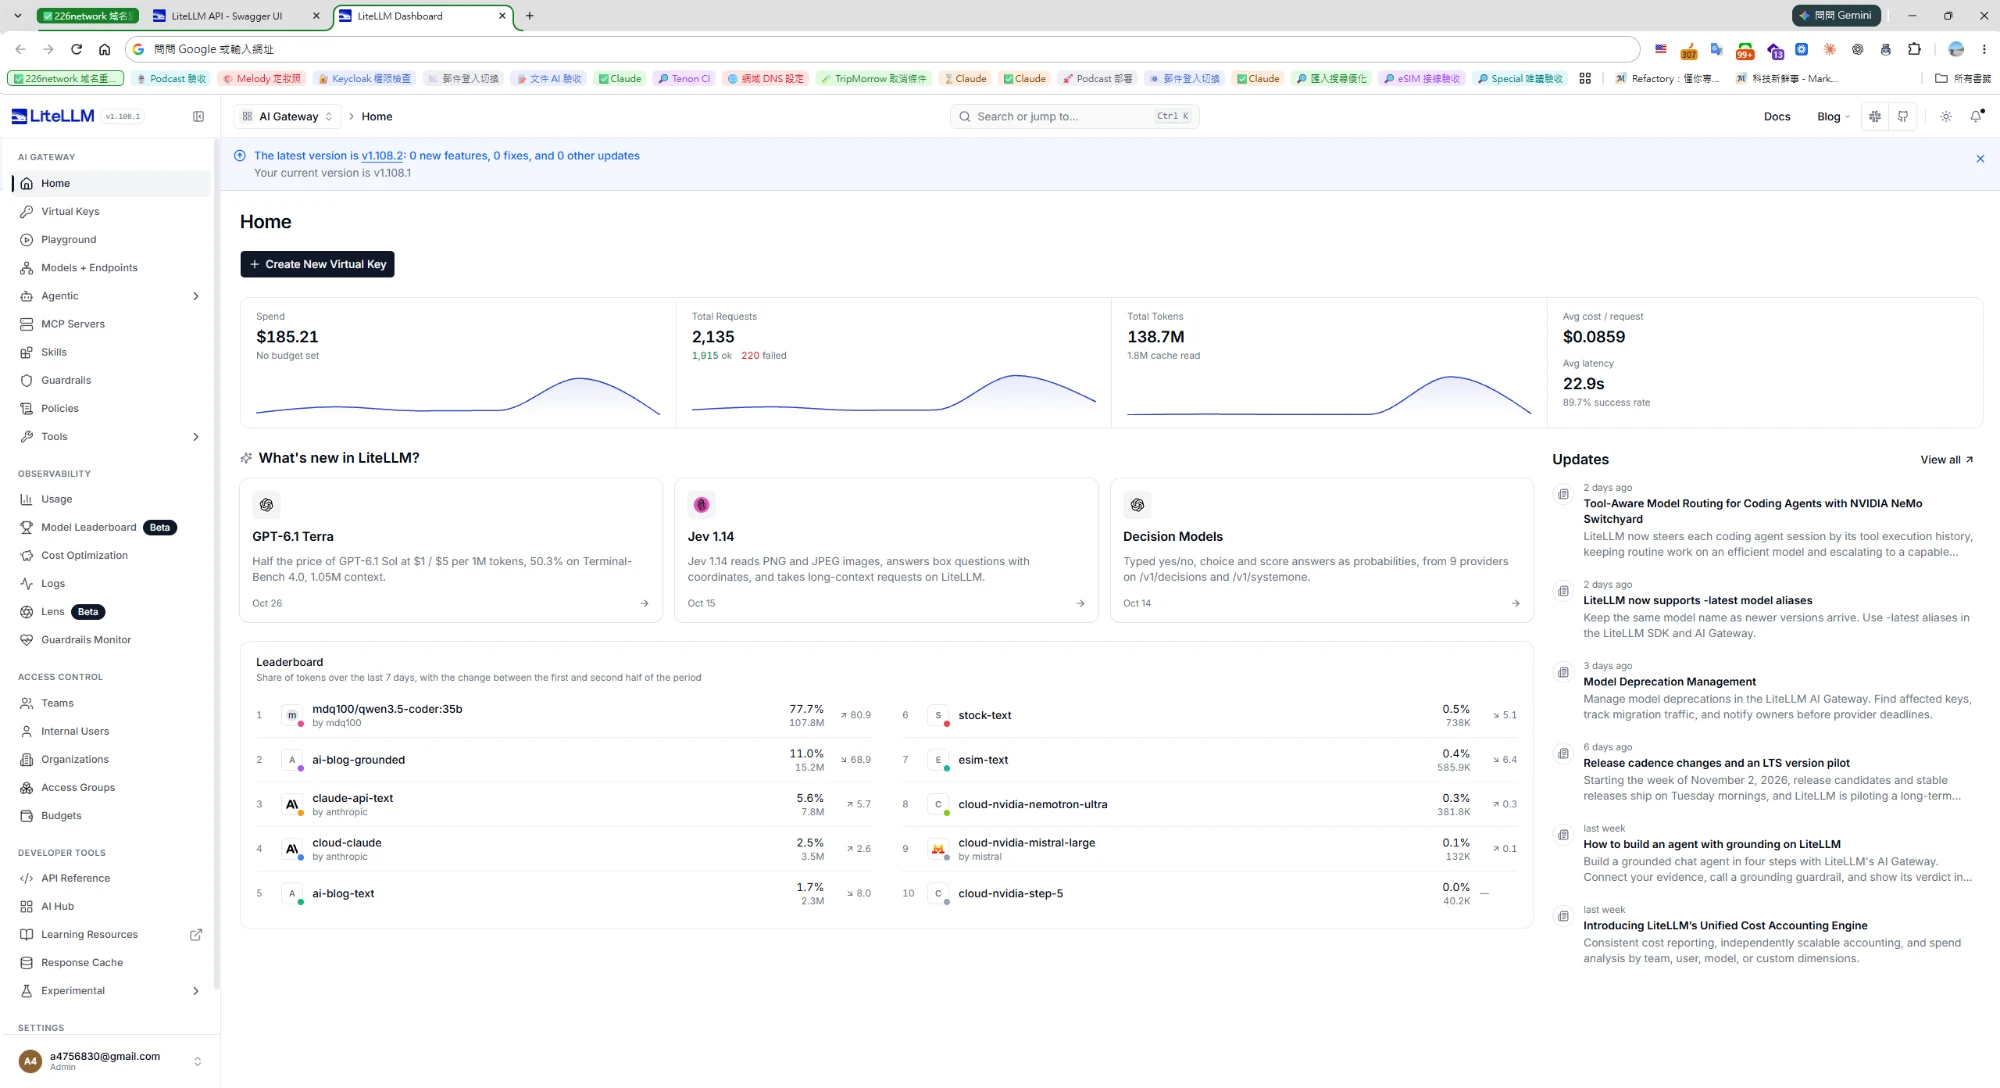
LiteLLM 的首頁儀表板把最關心的數字擺在最上面,這是我目前累積的數據:
| 指標 | 數值 |
|---|---|
| 總花費(Spend) | $185.21 |
| 總請求數 | 2,135(1,915 成功、220 失敗) |
| 總 Token | 1.387 億(其中 180 萬是 cache read) |
| 平均每次成本 | $0.0859 |
| 平均延遲 | 22.9 秒 |
| 成功率 | 89.7% |
下面的 Leaderboard 更有意思,它列出近 7 天各模型的 token 佔比:
mdq100/qwen3.5-coder:35b(地端 Ollama)佔 77.7%,1.078 億 tokens,花費是 0。ai-blog-grounded11.0%、claude-api-text5.6%、cloud-claude2.5%、ai-blog-text1.7%。stock-text、esim-text這類以應用命名的別名各佔不到 1%,NVIDIA 的幾個模型更少。
也就是說,接近八成的 token 是地端吃掉的,而它們一毛錢都沒算進 $185.21。批次、長文、程式碼這類不急的工作丟地端,付費額度留給真正需要品質的地方,這個分工在儀表板上一目了然。
費用怎麼算出來的
LiteLLM 每次呼叫都會依模型單價乘上 input/output token 記帳。常見雲端模型它內建價格表;查不到價格的就要自己填。從 Models + Endpoints 的 Costs 欄可以看出三種狀態:
- 地端 Ollama 顯示
IN $0.00 / OUT $0.00:我明確設成 0,代表「確定免費」。 aigen-web-image-gpt-image-2.5-flare顯示IN $5.00:手動填了單價,花費才會算進去。- NVIDIA 模型那欄是空的:沒有單價,所以不會產生花費。免費模型這樣沒問題,但如果哪天改走付費方案,記得回來補單價,不然儀表板會少算。
建議把「每個模型都有明確單價(就算是 0)」當成上線檢查項目,Spend 數字才值得相信。
五、金鑰管理:應用端不碰供應商金鑰
金鑰分成兩層:
| 層級 | 放在哪 | 誰拿得到 |
|---|---|---|
| 上游供應商金鑰(Anthropic、NVIDIA、OpenAI…) | Gateway 的 LLM Credentials | 只有 Gateway |
| Virtual Key | 各應用的環境變數 | 各應用自己 |
每個應用發一把自己的 Virtual Key,綁定可用模型、預算與速率:
curl -X POST "https://litellm.markkulab.net/key/generate" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "key_alias": "ai-blog",
    "models": ["text-default", "search-default", "image-default", "tts-default"],
    "max_budget": 20,
    "budget_duration": "30d",
    "rpm_limit": 30,
    "tpm_limit": 200000,
    "metadata": { "project": "ai-blog" }
  }'
這樣做的好處:
- 輪換上游金鑰只改一個地方,應用端完全無感。
- 某個應用的 key 外洩,撤銷那一把就好,其他應用照常運作,供應商金鑰也沒外流。
- 預算按
budget_duration自動重置,例如30d就是每 30 天歸零重算。注意單位:30m是 30 分鐘,不是 30 個月。 models白名單讓每個應用只能打它該用的別名,不會有人偷偷直連最貴的模型。
general_settings 裡的 master key 和資料庫連線同樣從環境變數讀,不要寫死在檔案裡:
general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL
  store_model_in_db: true   # 讓 Admin UI 新增的模型、Fallback 存進資料庫
六、實際接上 OpenCode
Gateway 架好之後,寫程式用的 Agent 也一起收進來。以 OpenCode 為例,把 LiteLLM 當成一個 OpenAI 相容的 provider 加進設定:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "litellm": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "LiteLLM (markkulab)",
      "options": {
        "baseURL": "https://litellm.markkulab.net/v1",
        "apiKey": "{env:LITELLM_API_KEY}"
      },
      "models": {
        "cloud-claude-sonnet": { "name": "Claude Sonnet 5 (LiteLLM)" },
        "cloud-claude-haiku": { "name": "Claude Haiku 4.5 (LiteLLM)" },
        "local-ollama-ornith-1.5-35b-text": { "name": "Local Ornith 1.5 35B" },
        "local-ollama-qwen3-coder-30b-text": { "name": "Local Qwen3 Coder 30B" },
        "local-ollama-qwen3-vl-8b-text": {
          "name": "Local Qwen3-VL 8B",
          "limit": { "context": 32768, "output": 8192 }
        }
      }
    }
  }
}
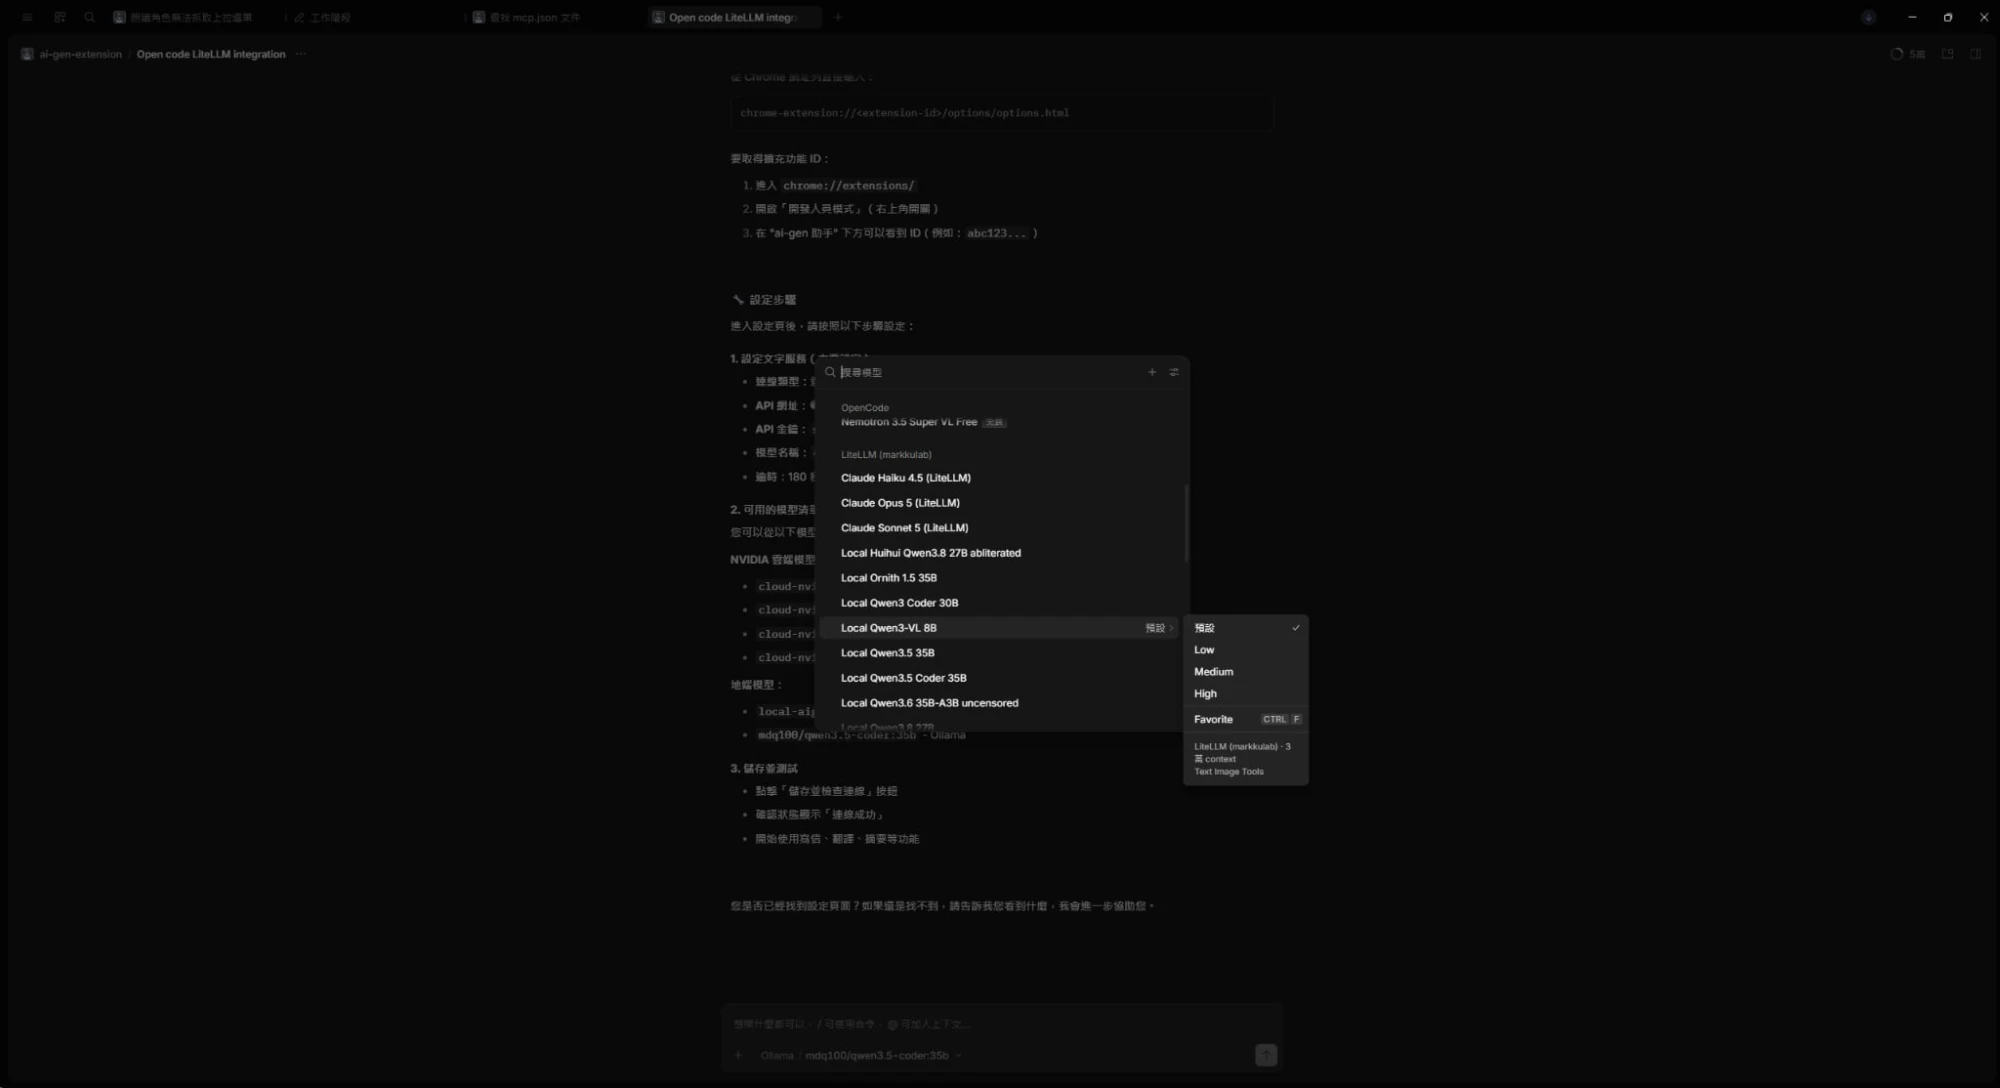
models 的 key 填 LiteLLM 上的 model_name,name 是 OpenCode 選單裡顯示的名字。設好之後 /models 會多出「LiteLLM (markkulab)」一整組,就是截圖裡的樣子:
- 雲端和地端在同一份清單:Claude Opus 5、Sonnet 5、Haiku 4.5 跟地端的 Qwen3.5 Coder 35B、Ornith 1.5 35B、Qwen3-VL 8B 排在一起,切換模型不用改任何 provider 設定。
- 金鑰只有一把 Virtual Key:OpenCode 這台機器上看不到任何 Anthropic 或 NVIDIA 的金鑰,
{env:LITELLM_API_KEY}從環境變數讀進來。 - 地端模型記得宣告
limit.context:地端模型的 context 通常比雲端小很多,告訴 OpenCode 上限,它才知道什麼時候該壓縮對話,不會塞爆之後回錯誤。 - 降級對 Agent 是透明的:選 Claude 時如果遇到 429,Gateway 會照 Fallback 鏈換模型,OpenCode 這邊不會中斷。代價是後面的模型能力可能比較弱,長任務跑到一半品質變差時,可以到 LiteLLM 的 Logs 看那幾次實際是哪個模型回的。
同一把 Virtual Key 的用量也會出現在儀表板上,Agent 吃了多少 token、花了多少錢,跟其他應用一起算得清清楚楚。
最小可跑的部署範例
想自己試的話,LiteLLM 加一個 PostgreSQL 就能跑起來(下面是範例,正式環境記得鎖定映像版本):
# docker-compose.yml
services:
  litellm:
    image: ghcr.io/berriai/litellm:main-stable
    command: ["--config", "/app/config.yaml", "--port", "4000"]
    ports:
      - "4000:4000"
    volumes:
      - ./config.yaml:/app/config.yaml:ro
    env_file: .env          # LITELLM_MASTER_KEY、DATABASE_URL、各家 API key
    depends_on:
      - postgres
    restart: unless-stopped

  postgres:
    image: postgres:16
    environment:
      POSTGRES_DB: litellm
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      - pgdata:/var/lib/postgresql/data
    restart: unless-stopped

volumes:
  pgdata:
起來之後打開 http://localhost:4000/ui,用 master key 登入就是截圖裡的 Admin UI。如果之後要跑多個 LiteLLM 實例,再加上 Redis 讓它們共用限速計數與冷卻狀態。
踩坑與取捨
1. Fallback 鏈太長,後面的模型輪不到
我的 cloud-claude 鏈有 8 個模型,但 LiteLLM Router 預設 max_fallbacks 只有 5。沒調大的話,最後面的地端兜底根本輪不到,等於白設。鏈長的人記得調這個值,並用 UI 的 ▶ 實際測一次。
2. 地端顯存是共用的
同一台 GPU 主機上的 Ollama 同時被叫起兩個 30B 等級的模型,很容易互搶顯存,結果回錯誤又觸發下一級 fallback,連鎖失敗。對策:
- Ollama 端設
OLLAMA_MAX_LOADED_MODELS、OLLAMA_NUM_PARALLEL控制同時載入與並行數。 - LiteLLM 端對地端部署設
rpm或max_parallel_requests,別讓 Gateway 一次塞太多進去。
3. 平均延遲 22.9 秒要分開看
這個數字被地端模型和長文生成拉高。即時互動(聊天、補全)的請求,鏈的前段應該放快的雲端模型;批次、長文、程式碼重構再優先丟地端。同一個別名不必服務所有情境,必要時多開一個專門給即時用的別名。
4. 有 Fallback 不代表不會失敗
儀表板上還是有 220 筆失敗。有些錯誤換模型也救不了,例如請求超過 context window、內容被安全政策擋下。LiteLLM 另外有 context_window_fallbacks、content_policy_fallbacks 可以針對這些情況指定去處;剩下的要到 Logs 一筆筆看原因。
5. UI 與 YAML 選一邊當主要來源
開了 store_model_in_db 之後,UI 改的設定存在資料庫,config.yaml 裡也有一份。兩邊都改很容易搞不清楚哪個才是現在生效的。我的做法是日常調整都在 UI,YAML 只放開機必要的設定。
結論
| 面向 | 以前 | 現在 |
|---|---|---|
| 模型管理 | 每個專案自己串供應商 | 一個入口、29 個模型、幾個用途別名 |
| 金鑰 | 供應商金鑰散落各專案 | 上游金鑰只在 Gateway,應用端只拿 Virtual Key |
| 成本 | 月底才知道 | 儀表板即時看 Spend、每個模型的 token 佔比 |
| 容錯 | 雲端 429 就停擺 | 自動降級,雲端都不行就落地端 |
| Token 經濟 | 全部付費 | 地端吃掉約 77.7% token,花費 0 |
接下來想做的事:
- 替每把 Virtual Key 設預算:儀表板目前還寫著「No budget set」,這是最該先補的。
- 用 Guardrails 做輸入過濾:在請求送上游前先擋掉個資和敏感內容。
- 接上 OpenTelemetry:目前只看得到聚合數字,想知道慢在排隊、推理還是降級。
如果你也有「多專案、多模型、成本失控、一掛就停」的困擾,從一份 config.yaml 加一個 PostgreSQL 開始,先把 text-default 的降級鏈跑通,體驗一次「雲端掛了地端頂上」,再慢慢把金鑰、預算和用量搬進來。


留言