---
title: "用 LiteLLM 自架地端 AI API Gateway:一個入口管所有模型,用量、費用、容錯移轉與金鑰一次搞定"
description: "用 LiteLLM Proxy 自架地端 AI API Gateway,單一 OpenAI 相容入口整合 29 款雲端與地端模型,實作用途別名、用量費用儀表板、多層 Fallback 鏈與虛擬金鑰管理,附完整 config.yaml 範例。"
canonical_url: "https://blog.markkulab.net/post/litellm-self-hosted-ai-api-gateway"
author: "Mark Ku"
author_url: "https://blog.markkulab.net/author/mark-ku"
site: "Mark Ku's Blog"
date_published: "2026-11-07T09:15:05.000Z"
category: "AI"
tags: ["LiteLLM", "AI Gateway", "Ollama", "NVIDIA NIM", "Fallback", "LLMOps", "成本管理"]
language: "zh-TW"
license: "CC BY 4.0"
license_url: "https://creativecommons.org/licenses/by/4.0/"
attribution: "轉載或引用請註明作者並附上原文連結"
---
# 用 LiteLLM 自架地端 AI API Gateway:一個入口管所有模型,用量、費用、容錯移轉與金鑰一次搞定
## 前言
我手上同時跑著好幾個會呼叫 AI 的專案:部落格產文與 podcast、股票小工具、eSIM 方案比對,再加上平常寫程式用的 Agent。以前每個專案各自串供應商:Claude 寫文章、NVIDIA 免費模型補量、OpenAI 出圖、區網的 Ollama 跑地端模型。結果就是三個老問題:
- **金鑰散落**:每個專案的 `.env` 都放著一份供應商金鑰,換一把要改好幾個地方。
- **成本看不清**:月底才知道哪個專案燒最多錢。
- **單點故障**:NVIDIA 額度用完、Claude 回 429,整條流程就停下來,得手動改程式換模型。
所以我自架了一台 **LiteLLM Proxy(v1.108)**,當作個人的地端 AI API Gateway,對外是 `https://litellm.markkulab.net`。所有應用都只打這一個 OpenAI 相容入口,由 Gateway 決定實際送去哪個模型、額度不夠時往下降級、順便把用量和花費記下來,上游金鑰也只放在它身上。
選 LiteLLM 的理由很實際:
1. **OpenAI 相容**:應用端只要換 `base_url` 和金鑰,程式幾乎不用改。
2. **雲端、地端一視同仁**:Anthropic、NVIDIA、OpenAI、Ollama、自架服務都是 `model_list` 裡的一列。
3. **治理功能內建**:Virtual Key、預算、限速、Fallback、用量儀表板,裝好就有,還有一套 Admin UI 可以直接在網頁上改。
## 整體架構
```mermaid
flowchart LR
subgraph Apps["應用端(各自一把 Virtual Key)"]
A1["部落格產文
podcast"]
A2["股票 / eSIM
小工具"]
A3["Agent / IDE
(OpenAI 相容)"]
end
subgraph GW["LiteLLM Proxy:地端 AI API Gateway"]
K["Virtual Key 驗證
預算・限速・可用模型"]
R["Router
用途別名 text-default / image-default…"]
F["Fallback 鏈
429・額度不足・逾時就往下掉"]
L[("PostgreSQL
用量・花費・Logs")]
C["LLM Credentials
上游金鑰集中保管"]
K --> R --> F
R -.記帳.-> L
C -.注入.-> F
end
subgraph Cloud["雲端"]
CL["Claude"]
NV["NVIDIA 免費模型
mistral-large・glm-flash
step-5・nemotron・flux"]
OA["OpenAI 出圖"]
end
subgraph Local["地端(區網 GPU)"]
OL["Ollama
qwen3.8・ornith・qwen3.5-coder"]
AG["ai-gen 出圖"]
TT["TTS 服務"]
end
A1 --> K
A2 --> K
A3 --> K
F --> CL
F --> NV
F --> OA
F --> OL
F --> AG
F --> TT
```
一個請求進來,依序經過三層:
1. **Virtual Key 驗證**:這把 key 能用哪些模型、還剩多少預算、每分鐘能打幾次。
2. **Router**:把應用指定的模型名稱(通常是用途別名)對到實際的部署。
3. **Fallback 鏈**:主模型失敗就照順序換下一個,雲端都不行就落到地端。
每一次呼叫的 token、花費、延遲、成功與否,都寫進 PostgreSQL,Admin UI 的儀表板就是從這裡算出來的。
## 一、整合雲端與地端模型
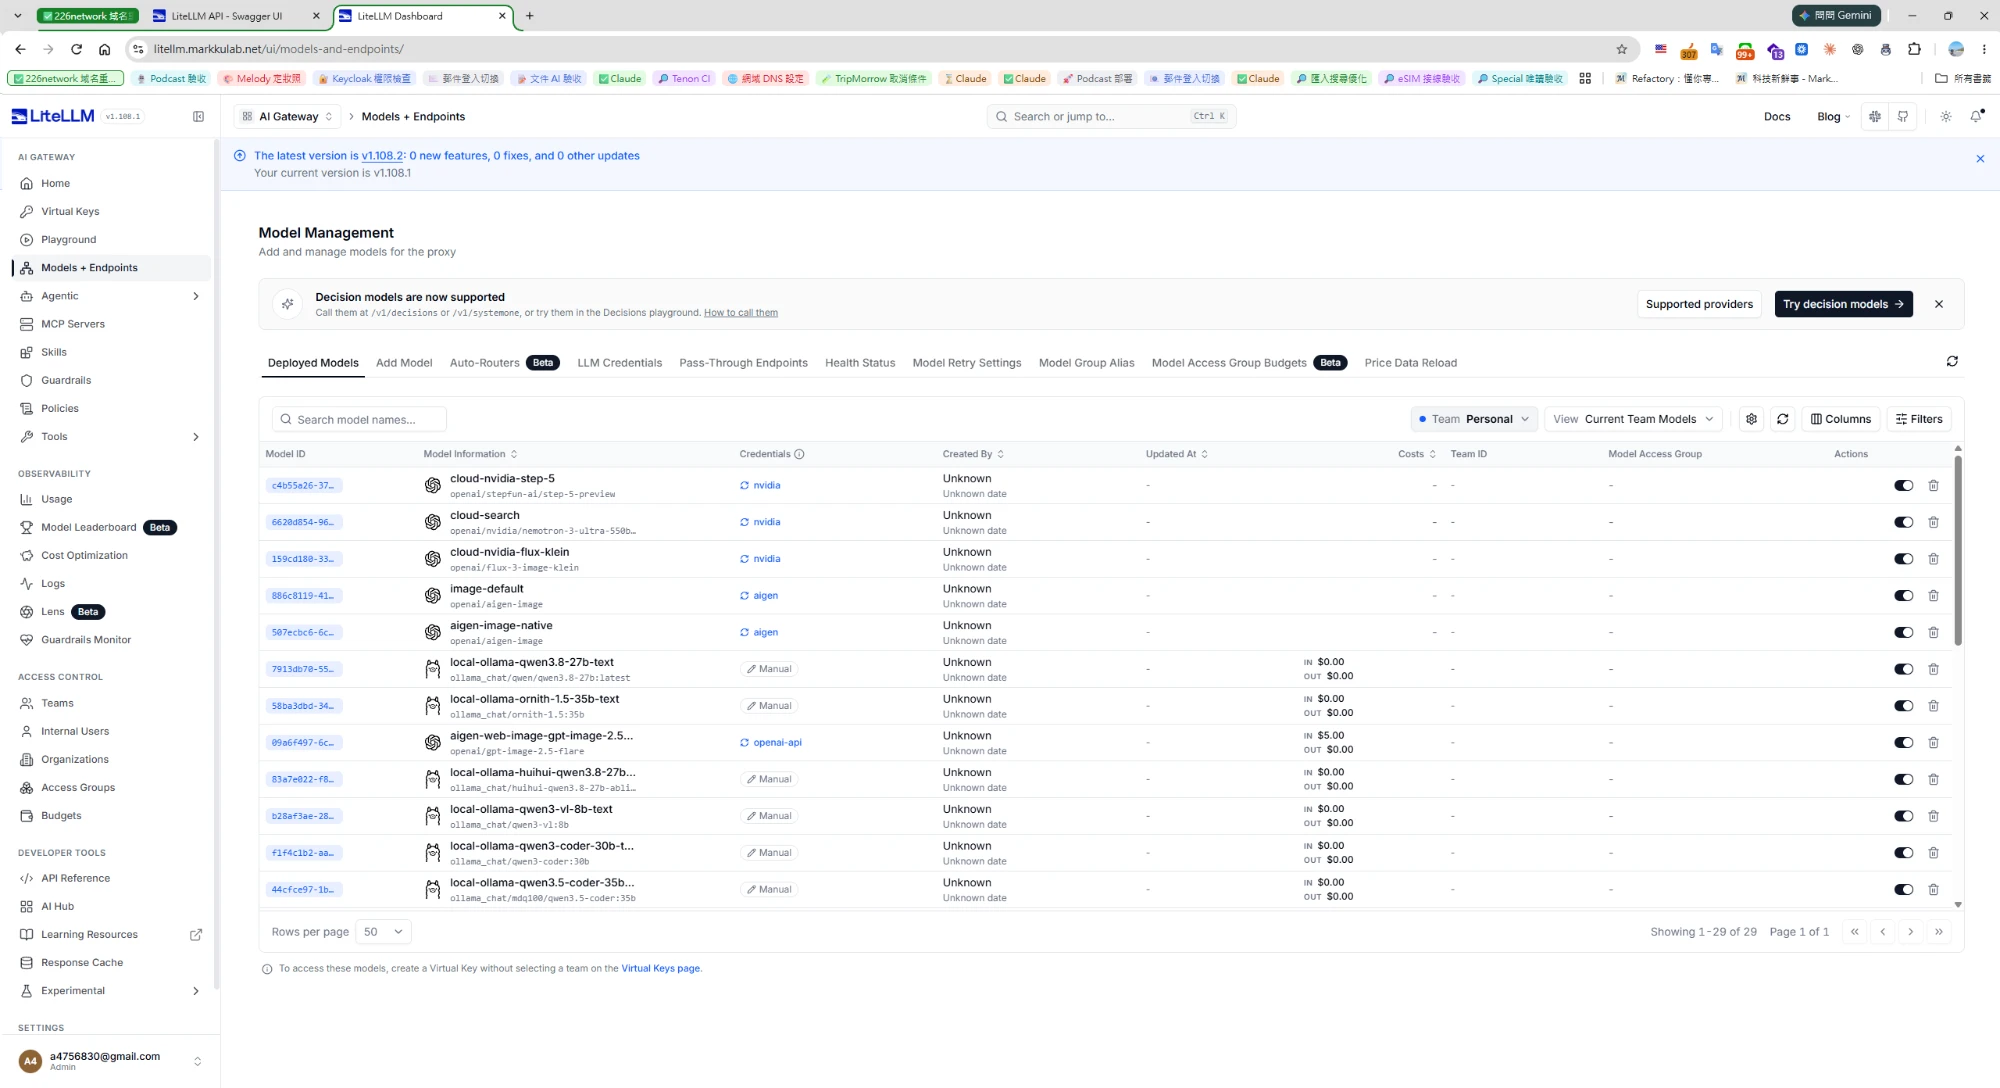
目前 Gateway 上註冊了 **29 個模型**,來源大致分四類:
| 來源 | 例子 | 憑證 |
|------|------|------|
| 雲端 Claude | `cloud-claude`、`cloud-claude-sonnet`、`cloud-claude-haiku` | Anthropic |
| NVIDIA 免費模型 | `cloud-nvidia-mistral-large`、`cloud-nvidia-glm-flash`、`cloud-nvidia-step-5`、`cloud-nvidia-nemotron-ultra`、`cloud-nvidia-nemotron-super-vl`、`cloud-nvidia-flux-klein`(出圖) | `nvidia` |
| 雲端出圖 | `cloud-openai-image`、`aigen-web-image-gpt-image-2.5-flare` | `openai-api` |
| 地端 | Ollama 的 `local-ollama-qwen3.8-27b-text`、`local-ollama-ornith-1.5-35b-text`、`local-ollama-qwen3-coder-30b-text`、`local-ollama-qwen3.5-coder-35b-text`、`local-ollama-qwen3-vl-8b-text`;自架出圖 `image-default`、`aigen-image-native` | `aigen`/Manual |
命名我刻意加上 `cloud-` 和 `local-` 前綴,看 Logs 或排行榜時,一眼就知道這筆是付錢的還是地端的。
截圖裡的 Credentials 欄位也值得注意:NVIDIA 模型都指向同一組 `nvidia` 憑證,ai-gen 指向 `aigen`,地端 Ollama 不需要金鑰所以顯示 Manual。上游金鑰只存在 Gateway,模型只是「引用」它,這點在下面的金鑰管理會再展開。
### config.yaml 範例
我平常大多在 Admin UI 上加模型,但用 YAML 表達比較好看懂。下面是縮減過的範例(金鑰一律從環境變數讀):
```yaml
# 可重複使用的上游憑證:模型只寫名字,不重複貼金鑰
credential_list:
- credential_name: nvidia
credential_values:
api_key: os.environ/NVIDIA_API_KEY
api_base: https://integrate.api.nvidia.com/v1
model_list:
# 雲端 Claude
- model_name: cloud-claude
litellm_params:
model: anthropic/claude-sonnet-5 # 換成你要用的版本
api_key: os.environ/ANTHROPIC_API_KEY
# NVIDIA 免費模型:走 OpenAI 相容格式,引用 nvidia 憑證
- model_name: cloud-nvidia-step-5
litellm_params:
model: openai/stepfun-ai/step-5-preview
litellm_credential_name: nvidia
# 地端 Ollama:單價明確設 0,儀表板才不會把它算進花費
- model_name: local-ollama-qwen3.8-27b-text
litellm_params:
model: ollama_chat/qwen/qwen3.8-27b:latest
api_base: http://:11434
input_cost_per_token: 0
output_cost_per_token: 0
```
`ollama_chat/` 前綴會走 Ollama 的 `/api/chat`,對多輪對話和工具呼叫的支援比 `ollama/` 好,地端聊天模型建議用這個。
## 二、用途別名:應用端只說「我要做什麼」
應用程式不寫死模型名稱,只呼叫幾個用途別名:
| 用途別名 | 用途 |
|----------|------|
| `text-default` | 一般文字生成、摘要、翻譯 |
| `search-default` | 需要上網查資料的任務 |
| `vision-default` | 看圖、OCR |
| `image-default` | 文字生圖 |
| `tts-default` | 語音合成 |
部落格這邊的做法是:環境變數沒指定模型時,一律退回這些別名,由 Gateway 決定實際模型與降級順序。要換模型、調順序、加一台地端主機,都只動 Gateway,應用端不用重新部署。
```python
import os
from openai import OpenAI
client = OpenAI(
base_url=os.environ["LITELLM_BASE_URL"], # 例如 https://litellm.markkulab.net/v1
api_key=os.environ["LITELLM_API_KEY"], # 這是 Virtual Key,不是供應商金鑰
)
resp = client.chat.completions.create(
model="text-default", # 只說用途,不指定廠牌
messages=[{"role": "user", "content": "幫我把這段整理成三點摘要"}],
)
print(resp.choices[0].message.content)
```
## 三、容錯移轉:額度用完自動降級
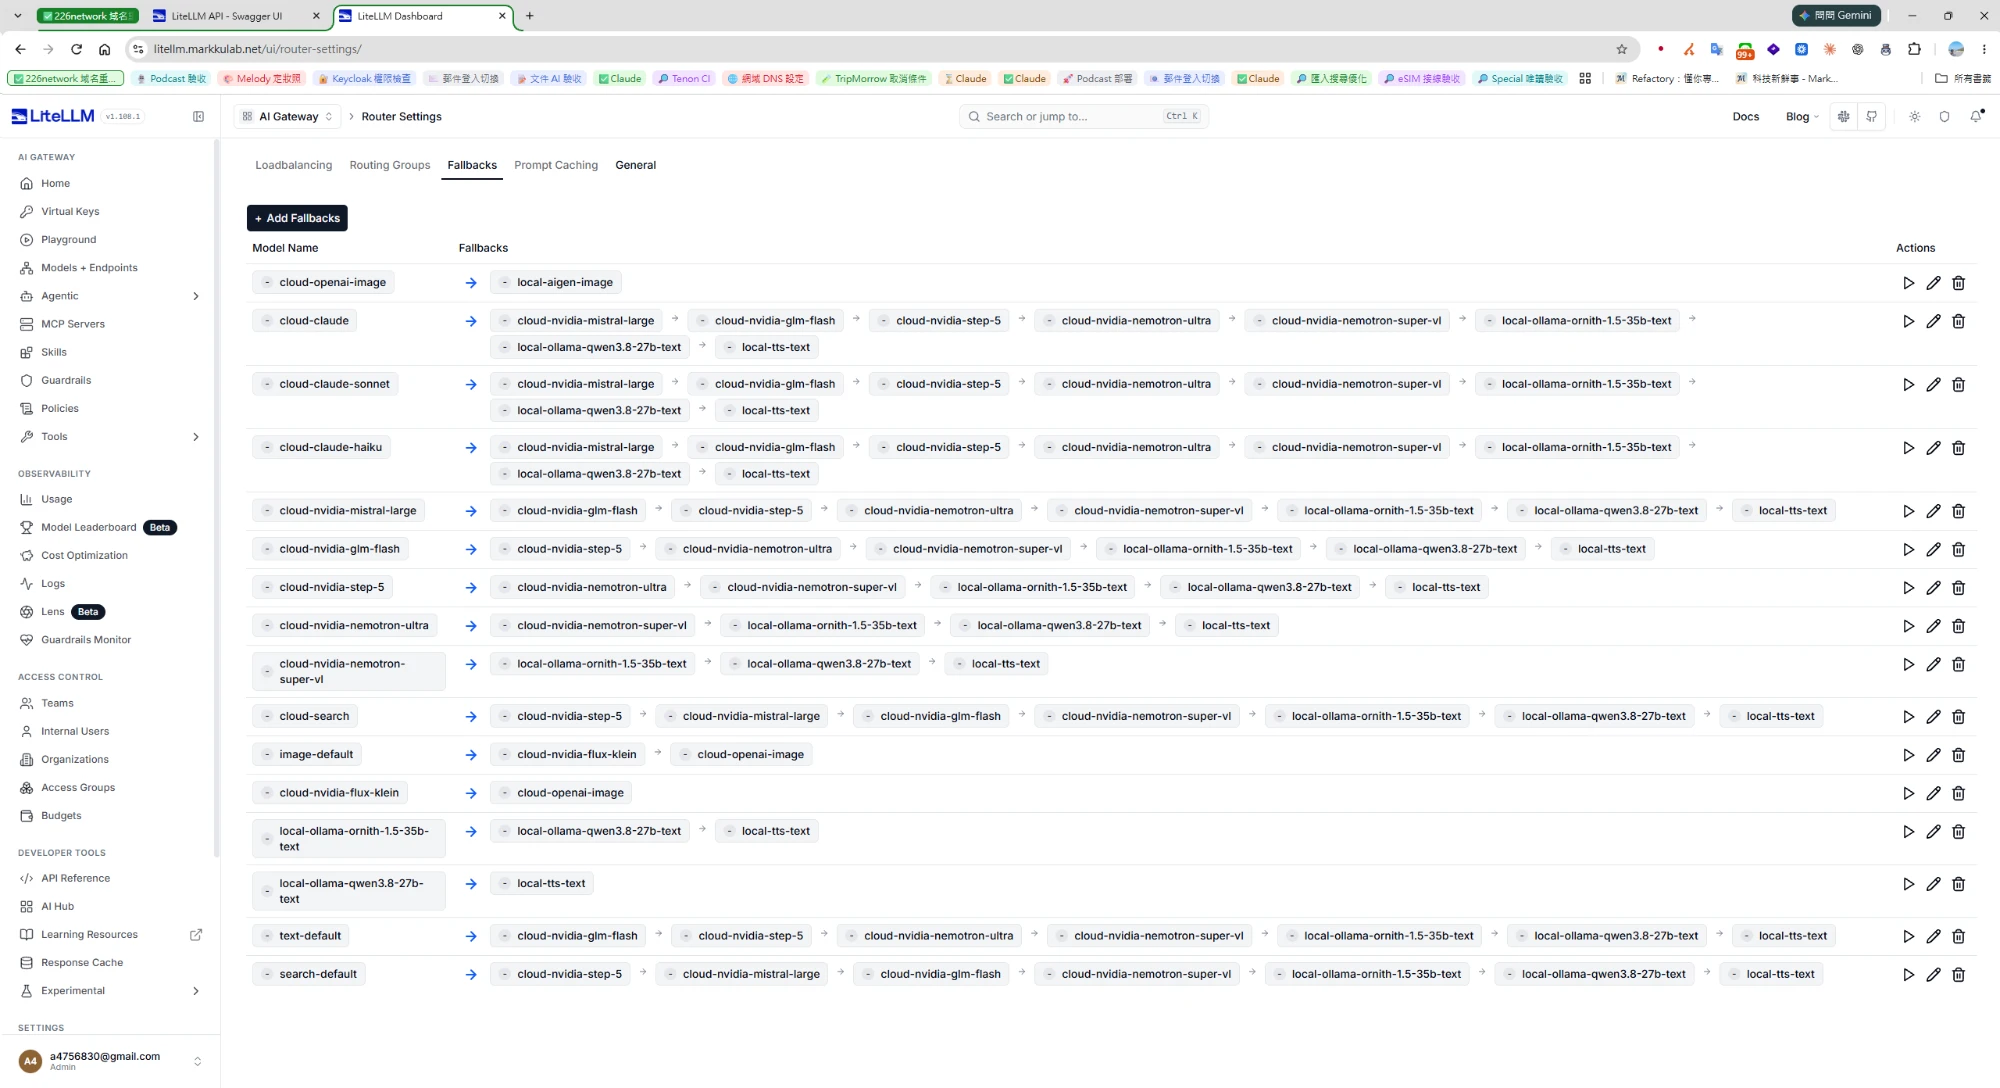
這是整套架構最有價值的部分。在 Router Settings 的 Fallbacks 分頁,每個模型都掛了自己的降級順序。以 `cloud-claude` 為例:
```mermaid
flowchart LR
A["cloud-claude
付費・品質最好"] -->|429 / 額度不足 / 逾時| B["NVIDIA
mistral-large"]
B --> C["NVIDIA
glm-flash"]
C --> D["NVIDIA
step-5"]
D --> E["NVIDIA
nemotron-ultra"]
E --> F["NVIDIA
nemotron-super-vl"]
F --> G["地端
ornith-1.5-35b"]
G --> H["地端
qwen3.8-27b"]
H --> I["地端
local-tts-text"]
```
原則是 **付費雲端 → 免費雲端 → 地端兜底**:
- **付費模型在最前面**,品質最好。
- **NVIDIA 免費模型接著上**,它們有速率限制,常回 429,但一個不行就換下一個,整體可用度還是很高。
- **地端放最後**,速度慢一點,但不會因為額度用完而失敗。
其他鏈也是同樣的思路:
| 模型 | 降級順序 |
|------|----------|
| `text-default` | glm-flash → step-5 → nemotron-ultra → nemotron-super-vl → 地端 ornith → 地端 qwen3.8 → local-tts-text |
| `search-default` | step-5 → mistral-large → glm-flash → nemotron-super-vl → 地端 ornith → 地端 qwen3.8 → local-tts-text |
| `image-default` | NVIDIA flux-klein → cloud-openai-image |
| `cloud-openai-image` | 地端 ai-gen 出圖 |
出圖這條是兩段式:`image-default` 失敗會換 NVIDIA 的 flux-klein,再不行換 OpenAI;而 `cloud-openai-image` 自己又掛了地端 ai-gen 當最後防線。
用 YAML 表達大概長這樣:
```yaml
router_settings:
num_retries: 2 # 同一個模型先重試幾次
allowed_fails: 3 # 一分鐘內失敗幾次就先冷卻
cooldown_time: 60 # 冷卻秒數,期間直接跳過這個部署
max_fallbacks: 10 # 預設只會往下試 5 個,鏈長的話要調大
fallbacks:
- cloud-claude:
- cloud-nvidia-mistral-large
- cloud-nvidia-glm-flash
- cloud-nvidia-step-5
- cloud-nvidia-nemotron-ultra
- cloud-nvidia-nemotron-super-vl
- local-ollama-ornith-1.5-35b-text
- local-ollama-qwen3.8-27b-text
- local-tts-text
```
在 Admin UI 的 Fallbacks 分頁,每一列右邊有一個 ▶ 按鈕可以直接測試整條鏈,改完順序先按一下,比上線後才發現斷鏈好得多。
## 四、用量統計與費用計算
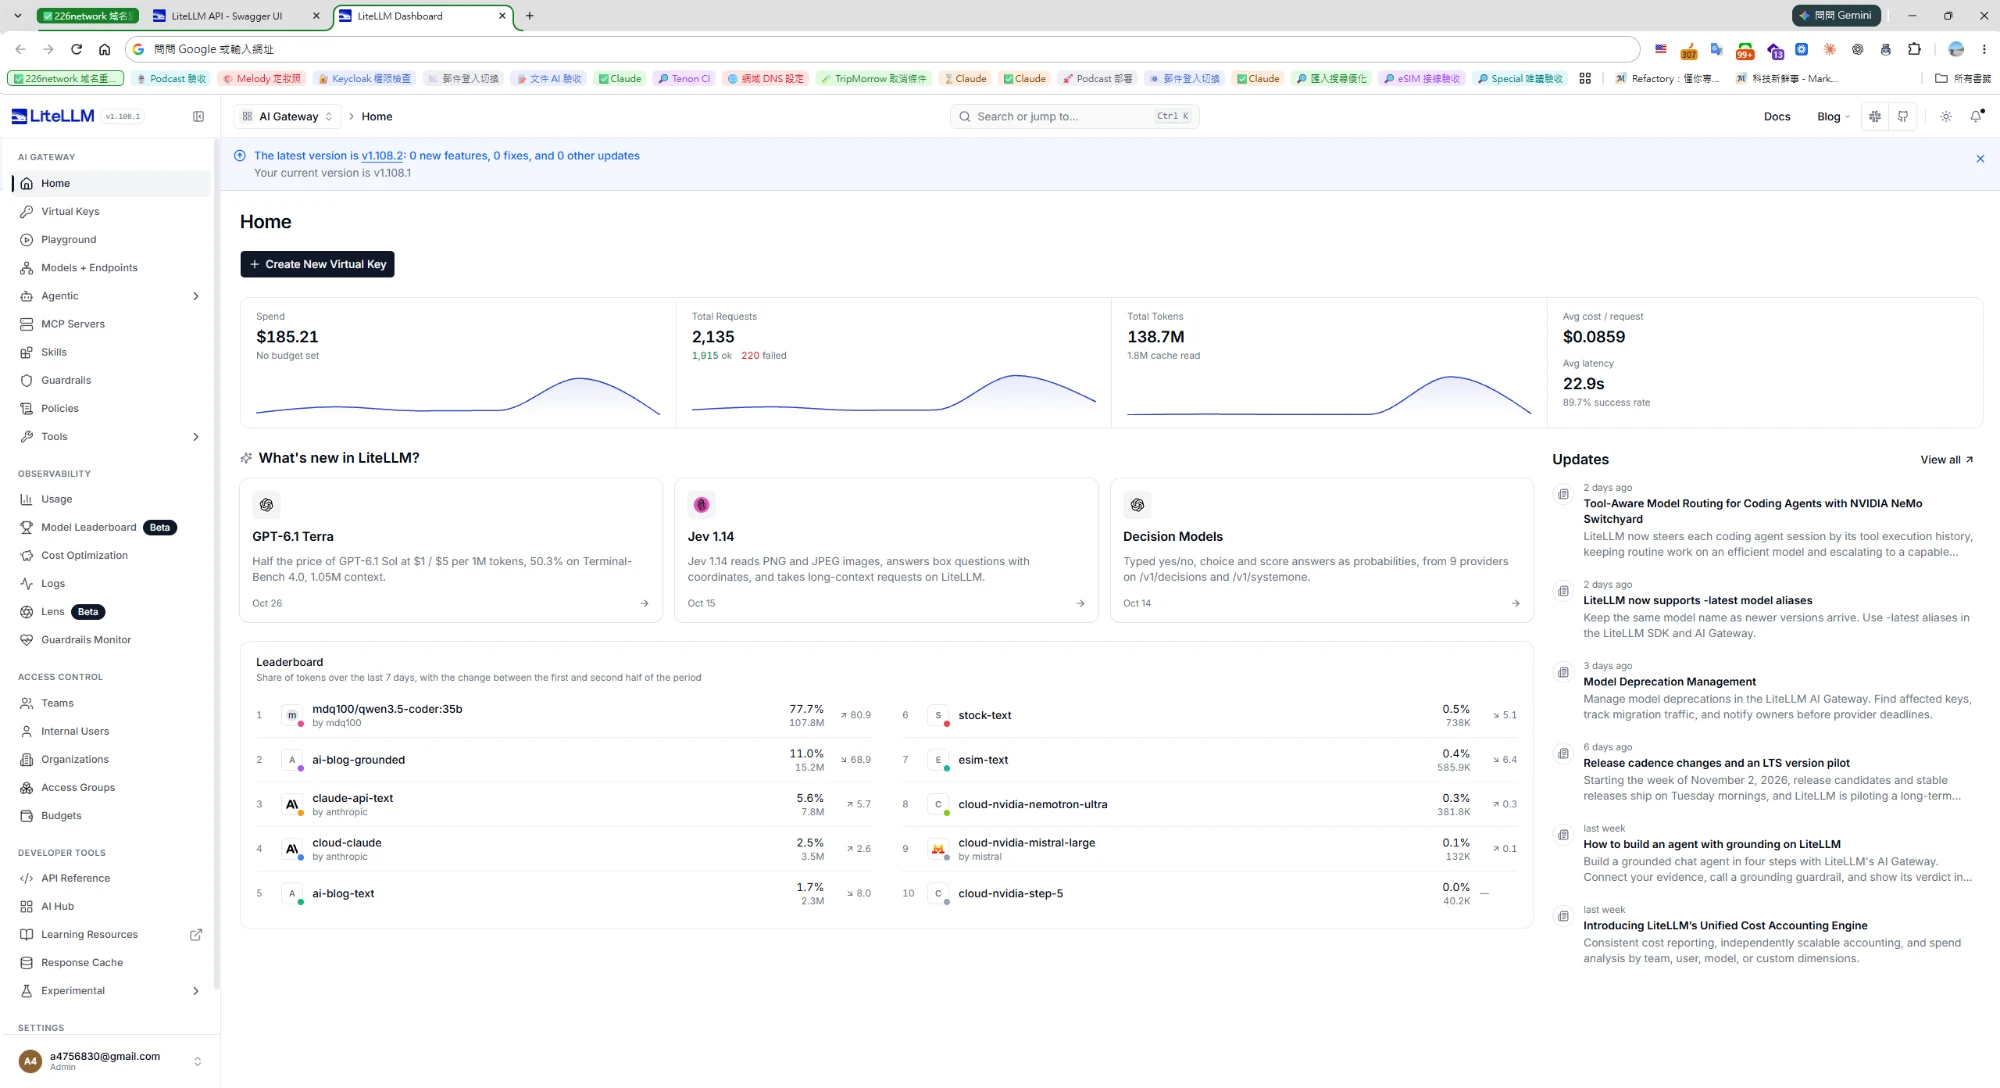
LiteLLM 的首頁儀表板把最關心的數字擺在最上面,這是我目前累積的數據:
| 指標 | 數值 |
|------|------|
| 總花費(Spend) | **$185.21** |
| 總請求數 | 2,135(1,915 成功、220 失敗) |
| 總 Token | 1.387 億(其中 180 萬是 cache read) |
| 平均每次成本 | $0.0859 |
| 平均延遲 | 22.9 秒 |
| 成功率 | 89.7% |
下面的 Leaderboard 更有意思,它列出近 7 天各模型的 token 佔比:
- **`mdq100/qwen3.5-coder:35b`(地端 Ollama)佔 77.7%**,1.078 億 tokens,花費是 0。
- `ai-blog-grounded` 11.0%、`claude-api-text` 5.6%、`cloud-claude` 2.5%、`ai-blog-text` 1.7%。
- `stock-text`、`esim-text` 這類以應用命名的別名各佔不到 1%,NVIDIA 的幾個模型更少。
也就是說,**接近八成的 token 是地端吃掉的,而它們一毛錢都沒算進 $185.21**。批次、長文、程式碼這類不急的工作丟地端,付費額度留給真正需要品質的地方,這個分工在儀表板上一目了然。
### 費用怎麼算出來的
LiteLLM 每次呼叫都會依模型單價乘上 input/output token 記帳。常見雲端模型它內建價格表;查不到價格的就要自己填。從 Models + Endpoints 的 Costs 欄可以看出三種狀態:
- **地端 Ollama 顯示 `IN $0.00 / OUT $0.00`**:我明確設成 0,代表「確定免費」。
- **`aigen-web-image-gpt-image-2.5-flare` 顯示 `IN $5.00`**:手動填了單價,花費才會算進去。
- **NVIDIA 模型那欄是空的**:沒有單價,所以不會產生花費。免費模型這樣沒問題,但如果哪天改走付費方案,記得回來補單價,不然儀表板會少算。
建議把「每個模型都有明確單價(就算是 0)」當成上線檢查項目,Spend 數字才值得相信。
## 五、金鑰管理:應用端不碰供應商金鑰
金鑰分成兩層:
| 層級 | 放在哪 | 誰拿得到 |
|------|--------|----------|
| 上游供應商金鑰(Anthropic、NVIDIA、OpenAI…) | Gateway 的 LLM Credentials | 只有 Gateway |
| Virtual Key | 各應用的環境變數 | 各應用自己 |
每個應用發一把自己的 Virtual Key,綁定可用模型、預算與速率:
```bash
curl -X POST "https://litellm.markkulab.net/key/generate" \
-H "Authorization: Bearer $LITELLM_MASTER_KEY" \
-H "Content-Type: application/json" \
-d '{
"key_alias": "ai-blog",
"models": ["text-default", "search-default", "image-default", "tts-default"],
"max_budget": 20,
"budget_duration": "30d",
"rpm_limit": 30,
"tpm_limit": 200000,
"metadata": { "project": "ai-blog" }
}'
```
這樣做的好處:
- **輪換上游金鑰只改一個地方**,應用端完全無感。
- **某個應用的 key 外洩,撤銷那一把就好**,其他應用照常運作,供應商金鑰也沒外流。
- **預算按 `budget_duration` 自動重置**,例如 `30d` 就是每 30 天歸零重算。注意單位:`30m` 是 30 分鐘,不是 30 個月。
- **`models` 白名單**讓每個應用只能打它該用的別名,不會有人偷偷直連最貴的模型。
`general_settings` 裡的 master key 和資料庫連線同樣從環境變數讀,不要寫死在檔案裡:
```yaml
general_settings:
master_key: os.environ/LITELLM_MASTER_KEY
database_url: os.environ/DATABASE_URL
store_model_in_db: true # 讓 Admin UI 新增的模型、Fallback 存進資料庫
```
## 六、實際接上 OpenCode
Gateway 架好之後,寫程式用的 Agent 也一起收進來。以 [OpenCode](https://blog.markkulab.net/post/opencode-cloud-free-models-ollama-mcp-skill-pitfall-guide) 為例,把 LiteLLM 當成一個 OpenAI 相容的 provider 加進設定:
```json
{
"$schema": "https://opencode.ai/config.json",
"provider": {
"litellm": {
"npm": "@ai-sdk/openai-compatible",
"name": "LiteLLM (markkulab)",
"options": {
"baseURL": "https://litellm.markkulab.net/v1",
"apiKey": "{env:LITELLM_API_KEY}"
},
"models": {
"cloud-claude-sonnet": { "name": "Claude Sonnet 5 (LiteLLM)" },
"cloud-claude-haiku": { "name": "Claude Haiku 4.5 (LiteLLM)" },
"local-ollama-ornith-1.5-35b-text": { "name": "Local Ornith 1.5 35B" },
"local-ollama-qwen3-coder-30b-text": { "name": "Local Qwen3 Coder 30B" },
"local-ollama-qwen3-vl-8b-text": {
"name": "Local Qwen3-VL 8B",
"limit": { "context": 32768, "output": 8192 }
}
}
}
}
}
```
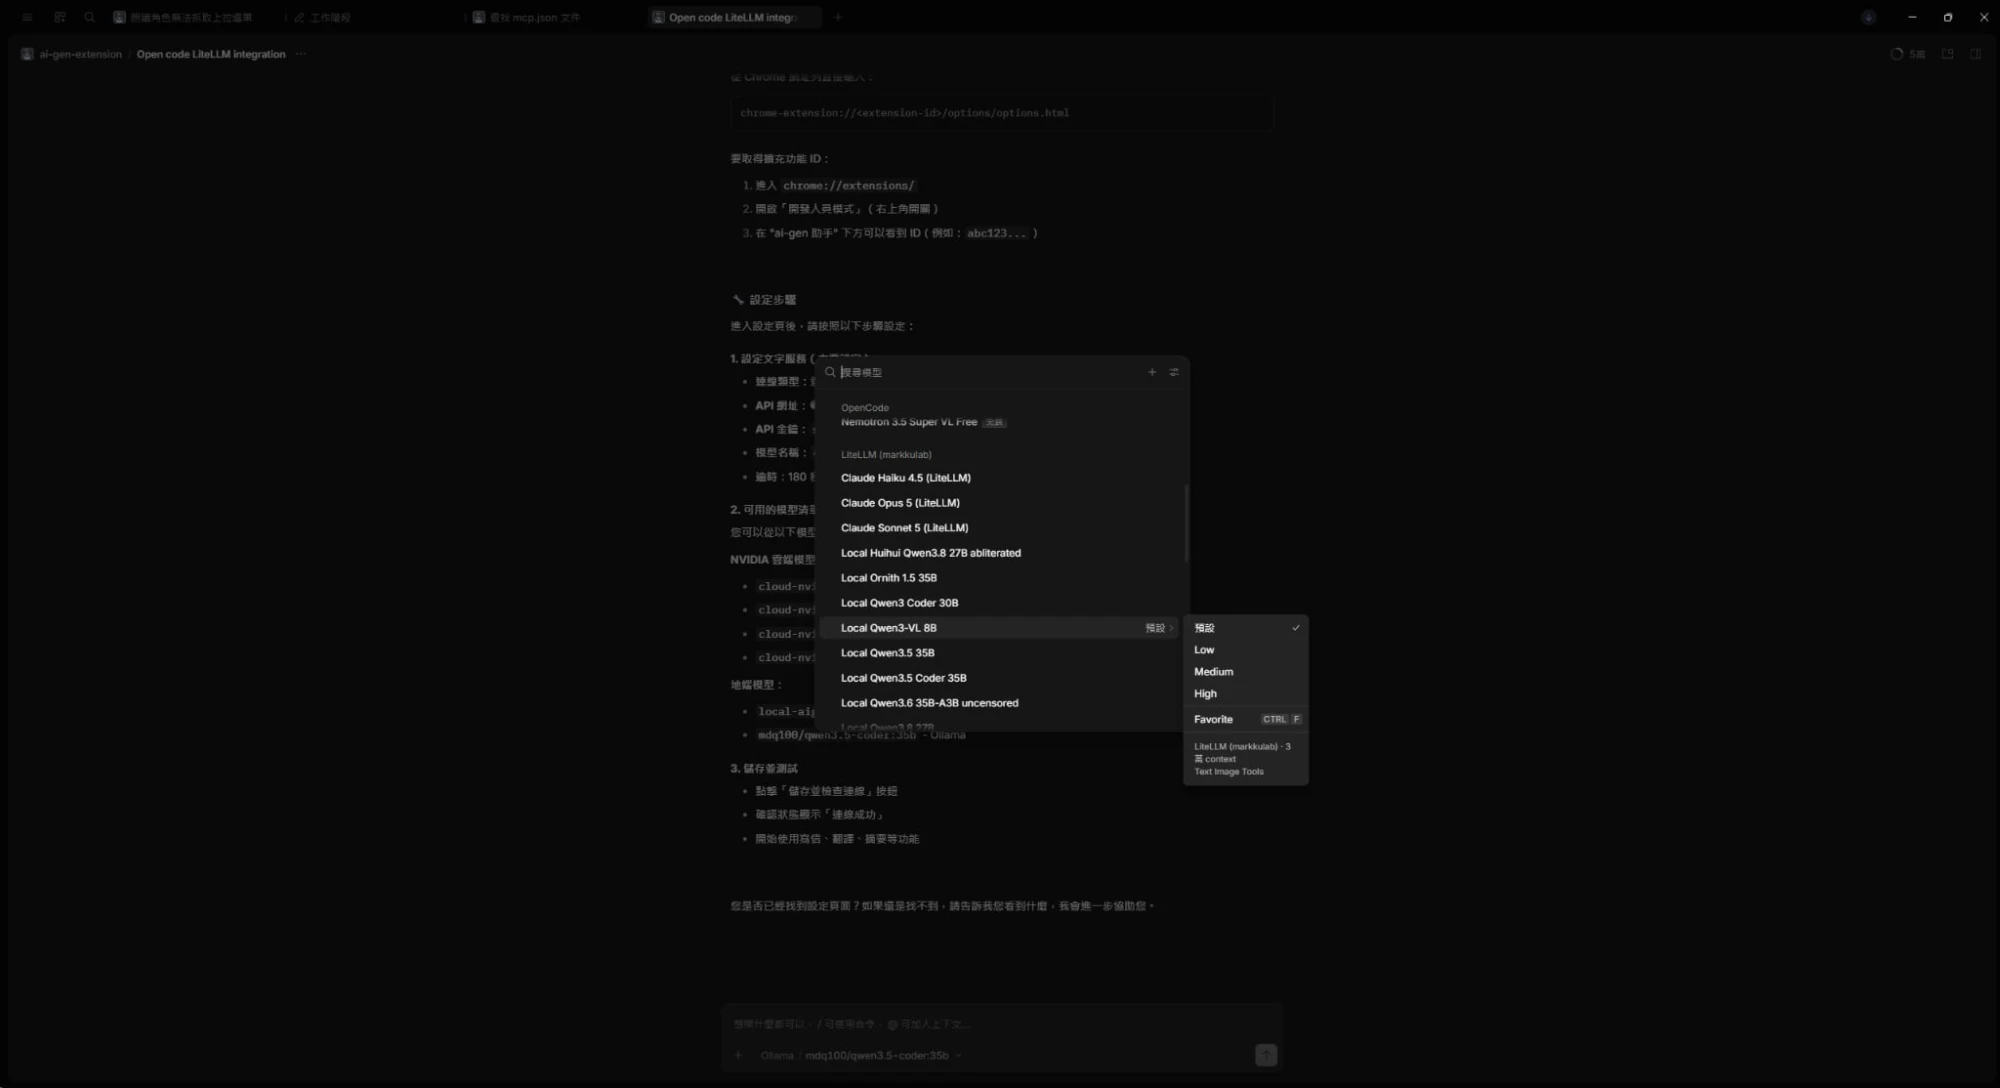
`models` 的 key 填 LiteLLM 上的 `model_name`,`name` 是 OpenCode 選單裡顯示的名字。設好之後 `/models` 會多出「LiteLLM (markkulab)」一整組,就是截圖裡的樣子:
- **雲端和地端在同一份清單**:Claude Opus 5、Sonnet 5、Haiku 4.5 跟地端的 Qwen3.5 Coder 35B、Ornith 1.5 35B、Qwen3-VL 8B 排在一起,切換模型不用改任何 provider 設定。
- **金鑰只有一把 Virtual Key**:OpenCode 這台機器上看不到任何 Anthropic 或 NVIDIA 的金鑰,`{env:LITELLM_API_KEY}` 從環境變數讀進來。
- **地端模型記得宣告 `limit.context`**:地端模型的 context 通常比雲端小很多,告訴 OpenCode 上限,它才知道什麼時候該壓縮對話,不會塞爆之後回錯誤。
- **降級對 Agent 是透明的**:選 Claude 時如果遇到 429,Gateway 會照 Fallback 鏈換模型,OpenCode 這邊不會中斷。代價是後面的模型能力可能比較弱,長任務跑到一半品質變差時,可以到 LiteLLM 的 Logs 看那幾次實際是哪個模型回的。
同一把 Virtual Key 的用量也會出現在儀表板上,Agent 吃了多少 token、花了多少錢,跟其他應用一起算得清清楚楚。
## 最小可跑的部署範例
想自己試的話,LiteLLM 加一個 PostgreSQL 就能跑起來(下面是範例,正式環境記得鎖定映像版本):
```yaml
# docker-compose.yml
services:
litellm:
image: ghcr.io/berriai/litellm:main-stable
command: ["--config", "/app/config.yaml", "--port", "4000"]
ports:
- "4000:4000"
volumes:
- ./config.yaml:/app/config.yaml:ro
env_file: .env # LITELLM_MASTER_KEY、DATABASE_URL、各家 API key
depends_on:
- postgres
restart: unless-stopped
postgres:
image: postgres:16
environment:
POSTGRES_DB: litellm
POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
volumes:
- pgdata:/var/lib/postgresql/data
restart: unless-stopped
volumes:
pgdata:
```
起來之後打開 `http://localhost:4000/ui`,用 master key 登入就是截圖裡的 Admin UI。如果之後要跑多個 LiteLLM 實例,再加上 Redis 讓它們共用限速計數與冷卻狀態。
## 踩坑與取捨
### 1. Fallback 鏈太長,後面的模型輪不到
我的 `cloud-claude` 鏈有 8 個模型,但 LiteLLM Router 預設 `max_fallbacks` 只有 5。沒調大的話,最後面的地端兜底根本輪不到,等於白設。鏈長的人記得調這個值,並用 UI 的 ▶ 實際測一次。
### 2. 地端顯存是共用的
同一台 GPU 主機上的 Ollama 同時被叫起兩個 30B 等級的模型,很容易互搶顯存,結果回錯誤又觸發下一級 fallback,連鎖失敗。對策:
- Ollama 端設 `OLLAMA_MAX_LOADED_MODELS`、`OLLAMA_NUM_PARALLEL` 控制同時載入與並行數。
- LiteLLM 端對地端部署設 `rpm` 或 `max_parallel_requests`,別讓 Gateway 一次塞太多進去。
### 3. 平均延遲 22.9 秒要分開看
這個數字被地端模型和長文生成拉高。即時互動(聊天、補全)的請求,鏈的前段應該放快的雲端模型;批次、長文、程式碼重構再優先丟地端。同一個別名不必服務所有情境,必要時多開一個專門給即時用的別名。
### 4. 有 Fallback 不代表不會失敗
儀表板上還是有 220 筆失敗。有些錯誤換模型也救不了,例如請求超過 context window、內容被安全政策擋下。LiteLLM 另外有 `context_window_fallbacks`、`content_policy_fallbacks` 可以針對這些情況指定去處;剩下的要到 Logs 一筆筆看原因。
### 5. UI 與 YAML 選一邊當主要來源
開了 `store_model_in_db` 之後,UI 改的設定存在資料庫,`config.yaml` 裡也有一份。兩邊都改很容易搞不清楚哪個才是現在生效的。我的做法是日常調整都在 UI,YAML 只放開機必要的設定。
## 結論
| 面向 | 以前 | 現在 |
|------|------|------|
| 模型管理 | 每個專案自己串供應商 | 一個入口、29 個模型、幾個用途別名 |
| 金鑰 | 供應商金鑰散落各專案 | 上游金鑰只在 Gateway,應用端只拿 Virtual Key |
| 成本 | 月底才知道 | 儀表板即時看 Spend、每個模型的 token 佔比 |
| 容錯 | 雲端 429 就停擺 | 自動降級,雲端都不行就落地端 |
| Token 經濟 | 全部付費 | 地端吃掉約 77.7% token,花費 0 |
接下來想做的事:
1. **替每把 Virtual Key 設預算**:儀表板目前還寫著「No budget set」,這是最該先補的。
2. **用 Guardrails 做輸入過濾**:在請求送上游前先擋掉個資和敏感內容。
3. **接上 OpenTelemetry**:目前只看得到聚合數字,想知道慢在排隊、推理還是降級。
如果你也有「多專案、多模型、成本失控、一掛就停」的困擾,從一份 `config.yaml` 加一個 PostgreSQL 開始,先把 `text-default` 的降級鏈跑通,體驗一次「雲端掛了地端頂上」,再慢慢把金鑰、預算和用量搬進來。
## 參考資料
- [LiteLLM 官方文件:Proxy Server](https://docs.litellm.ai/docs/proxy)
- [LiteLLM 官方文件:Fallbacks、重試與冷卻](https://docs.litellm.ai/docs/proxy/reliability)
- [LiteLLM 官方文件:Virtual Keys](https://docs.litellm.ai/docs/proxy/virtual_keys)
- [LiteLLM 官方文件:Cost Tracking](https://docs.litellm.ai/docs/proxy/cost_tracking)
- [Ollama API 文件](https://github.com/ollama/ollama/blob/main/docs/api.md)
- [Docker 安裝 AI 大型語言模型 Ollama,並實測比較 CPU 與 GPU 硬體加速效能](https://blog.markkulab.net/post/build-your-ollama-ai-with-hardware-acceleration)
- [NVIDIA 免費 AI API 實測及條款](https://blog.markkulab.net/post/nvidia-free-llm-api-limits-and-terms)
- [Token Monitor 實測與團隊版改造](https://blog.markkulab.net/post/token-monitor-ai-token-dashboard)
- [更彈性且開源的 API Gateway APISIX](https://blog.markkulab.net/post/apisix-openresty-gateway)
- [先工具、再 MCP、最後 Agent:用 Hermes Agent 打造全地端 AI 助理](https://blog.markkulab.net/post/hermes-agent-local-mcp-lora)
---
## 關於本文與作者
本文出自 [Mark Ku's Blog](https://blog.markkulab.net/post/litellm-self-hosted-ai-api-gateway)
授權條款: [CC BY 4.0](https://creativecommons.org/licenses/by/4.0/) — 轉載或引用請註明作者並附上原文連結
### 關於作者
**[Mark Ku](https://blog.markkulab.net/author/mark-ku)** — 軟體工程師
- 10 年以上軟體工程師
- 做過北美電商與 AI SaaS 訂閱收費系統
### 作者開發的免費工具
以下工具皆可免費使用:
- [免費 PDF 簽名工具](https://blog.markkulab.net/tools/pdf-sign): 線上 PDF 簽名工具,瀏覽器內完成手繪、打字、上傳簽名,可拖曳放置、縮放、下載。所有處理都在你的裝置完成,檔案不會上傳。
- [VS Code Refactory](https://blog.markkulab.net/tools/refactory): Refactory 是一款 VS Code 重構擴充套件:34 個重構動作、37 條 code smell 檢查、Code Health 儀表板、18 種語言、534 支測試。懂你的專案慣例:介面放哪、DI 註冊寫在哪、'use client' 該不該加;還會用 git 修改頻率 × 複雜度排出「該先修哪個檔案」,並一鍵把壞味道交給你自己電腦上的 Claude Code 修。免費使用,原始碼不離開你的機器。
- [DB-Kit 資料庫管理工具](https://blog.markkulab.net/tools/db-kit): DB-Kit 是一個用 Tauri + Rust + React 打造的輕量跨平台資料庫管理工具,用單一一致的介面同時管理 MySQL、MariaDB、PostgreSQL、SQL Server、Oracle、SQLite、MongoDB、Redis、Kafka、Elasticsearch 與 RabbitMQ 十一種資料來源:連線密碼以 OS keychain 加密、SSH Tunnel、完整 CRUD、視覺化查詢建構器、多結果集同時顯示、跨連線資料傳輸、結構與資料比對(同步 SQL、結構快照)、Excel / CSV 匯入匯出、執行計畫視覺化、ER 圖、排程備份、SQL 壓力測試(p50~p99 延遲百分位)、15 條規則的 SQL 審查、執行前 AI 審查並逐句備份的「審查並執行」(自動產生回滾腳本)、Kafka 訊息瀏覽與監控告警、SSH 終端機與 SFTP / FTP、Docker / Kubernetes、遠端桌面(RDP / VNC / RustDesk)、檔案 / 資料夾比對、預存程序整合測試;六種介面語言,內建 AI 助手(本機 CLI 或 Anthropic / OpenAI 相容 API,自然語言生成 SQL、AI 審查與調校建議)與命令列工具 dbk。免費開源(MIT),提供 Windows / macOS / Linux 安裝檔。
- [VS Code Super Mermaid](https://blog.markkulab.net/tools/super-mermaid): Super Mermaid 是一款 VS Code 擴充套件:開箱即用的漂亮 Mermaid 圖表,自動上色、即時預覽、滑鼠平移縮放、PNG / SVG 高解析匯出,內建 21 種範本與多種主題。免費開源(MIT)。
- [React Super Mermaid](https://blog.markkulab.net/tools/react-super-mermaid): react-super-mermaid 是一個開源 React 元件庫:一行 即可渲染漂亮的 Mermaid 圖表,內建 colorful / sketch 主題、平移縮放、圖內搜尋、SVG / PNG 高解析匯出。輕量、SSR 安全、完整 TypeScript 型別。免費開源(MIT)。
- [Jira / Confluence Super Mermaid](https://blog.markkulab.net/tools/jira-super-mermaid): Atlassian Forge app:在 Jira issue 與 Confluence 內文直接寫 Mermaid 語法,畫流程圖、時序圖、狀態機與甘特圖。11 種圖表、SVG / PNG 匯出、明暗主題、完整中日韓文字支援。取得 Runs on Atlassian 資格:圖表存在你自己的站台,app 不呼叫任何第三方服務。免費,即將上架 Atlassian Marketplace。
- [Mermaid 線上預覽](https://blog.markkulab.net/tools/mermaid-preview): 在瀏覽器裡寫 Mermaid、即時看圖,整張圖表壓進網址就能分享。免註冊、不上傳伺服器,相容 mermaid.live 的分享連結。
- [React Intl Phone Number](https://blog.markkulab.net/tools/react-intl-phone-number): react-intl-phone-number 是一個開源 React 元件:framework-agnostic、不依賴 antd,提供 E.164 進出、可搜尋國旗 / 國碼下拉、可配置驗證等級(strict / mobile-strict / loose)、可主題化 CSS 與 i18n,電話邏輯由 google-libphonenumber 驅動。輕量、完整 TypeScript 型別。免費開源(MIT)。
- [Uptime Kuma Cluster](https://blog.markkulab.net/tools/uptime-kuma-cluster): 把單機版 Uptime Kuma 改造成高可用叢集:OpenResty + Lua 智慧負載平衡、MariaDB 共享狀態、健康檢查與自動 Failover,附監控與叢集管理 RESTful API,一行 Docker Compose 啟動。免費開源(MIT)。
- [AI Podcast Cut 音檔剪輯](https://blog.markkulab.net/tools/ai-podcast-cut): 丟進一段錄音,AI 幫你剪掉「嗯、呃、那個」與講到一半重講的片段,平衡逐段音量,並派第二個 agent 覆核每一刀。辨識與去人聲都在你自己的電腦上跑,不上傳、不需要金鑰。剪點會貼齊字邊界與零交越、每一刀都有漸弱漸強,句尾還留得住呼吸感。Windows / macOS / Linux 桌面應用,MIT 開源,Windows 安裝檔內建 ffmpeg。
- [AI Video Cut 影片剪輯](https://blog.markkulab.net/tools/ai-video-cut): 在影片裡選一個東西:打字(人臉、車牌、手機螢幕、logo)、手動點選或拖框,或交給 Claude Code / Codex 挑。AI Video Cut 會逐幀追蹤它,再幫你打馬賽克或模糊、調色、加跟著走的貼紙與文字、把螢幕或海報換成你的圖片或影片,甚至用其他幀拍到的背景把它移除。另有序列剪輯、本機字幕與 AI 助手。免費開源(MIT)的 Windows 桌面應用(macOS / Linux 實驗中),本機運行,影片不上傳。
- [open-pos 開源餐飲 POS](https://blog.markkulab.net/tools/open-pos): 一台電腦加一台出單機就能開店。資料存在自己的硬碟裡、沒有月租、沒有綁約,MIT 全開源。金額用整數元依營業稅法拆算稅額,銷售額加稅額恆等於總額;出單走網路型 ESC/POS(TCP 9100),不必裝廠商驅動。Tauri + Rust + SQLite 桌面應用,v1.0 開發中。
- [.NET 電商 API 架構範本](https://blog.markkulab.net/tools/dotnet-ecommerce-api): 以 .NET 10 打造的電商平台後端 API 架構範本:Controller → Service → Repository 分層、Autofac 依命名慣例自動註冊、SqlSugar 支援 MySQL / MariaDB 與 SQL Server、Redis 快取與訊息佇列、Hangfire 排程、JWT 認證,內建可擴充的金流 Provider 模組(綠界 ECPay、藍新 Newebpay)。Apache 2.0 開源。
- [Open Token Monitor 團隊 AI 用量監控](https://blog.markkulab.net/tools/open-token-monitor): 把每位員工電腦上 AI coding 工具的 token 用量與等值成本集中到公司自架的 hub:PostgreSQL、組織名單、依公司與部門比較的 dashboard、報表 API。員工端有 Electron 與 Rust/Tauri 兩種,每 30 分鐘自動上傳。MIT 開源,Docker 一行起。
- [AI 資安監控 ai-security-monitor](https://blog.markkulab.net/tools/ai-security-monitor): 網站上線了,漏洞、憑證與安全設定誰來檢查?ai-security-monitor 用自架 Security Hub 集中網站掃描與主機監控,合併重複發現、比對修補前後,讓你知道哪些問題還沒處理。
### 每日 Podcast
- [Mark's Tech Insights 每日 AI 新鮮事](https://blog.markkulab.net/category/tech-news): 每日精選 AI 與科技趨勢,透過語音摘要快速掌握最新技術動態,涵蓋 AI 應用、軟體架構、DevOps 與工程實戰。 — RSS: https://blog.markkulab.net/feed.xml
- [AI股市蝦聊](https://blog.markkulab.net/category/ai-stock-chat): 每個交易日用 AI 分析台股盤勢,以雙人對話聊當天的盤中觀察與隔日預測。 — RSS: https://blog.markkulab.net/ai-stock-chat/feed.xml
- [開源好物日報](https://blog.markkulab.net/category/open-source-weekly): 每天從 Hacker News、GitHub、Reddit 聲量雷達精選免費開源工具,以雙人對話聊解決什麼痛點與怎麼快速上手。 — RSS: https://blog.markkulab.net/open-source-weekly/feed.xml
- [AI 運動日報](https://blog.markkulab.net/category/sports-weekly): 每天以雙人對話聊 NBA、MLB 與國際體壇大事,台灣球迷視角,輕鬆有梗不酸人。 — RSS: https://blog.markkulab.net/sports-weekly/feed.xml
- [AI 國際新聞快報](https://blog.markkulab.net/category/world-news): 每天早上以雙人對話把過去一天的國際大事講白:政治外交、全球經濟、衝突與安全、災害與氣候,台灣視角、中立客觀、每則附出處。 — RSS: https://blog.markkulab.net/world-news/feed.xml
- [地端 AI 實驗室](https://blog.markkulab.net/category/local-ai-lab): 每天精選可以下載到自己機器上跑的開源模型與 LoRA,用雙人對話講清楚能用在哪些場景、你的顯卡跑不跑得動、跟同類差在哪,規格一律引述官方 model card。 — RSS: https://blog.markkulab.net/local-ai-lab/feed.xml
- [AI 行銷日報](https://blog.markkulab.net/category/ai-marketing): 每天以雙人對話整理最新 AI 在行銷、廣告、SEO/GEO 與內容行銷的大事,實戰視角、不業配、每則附出處。 — RSS: https://blog.markkulab.net/ai-marketing/feed.xml
- [AI 資安日報](https://blog.markkulab.net/category/ai-security): 每天以雙人對話整理最新 AI 與資安交會的大事:LLM 與 AI agent 漏洞、prompt injection、模型供應鏈、攻擊者怎麼用 AI,防禦視角、每則附出處。 — RSS: https://blog.markkulab.net/ai-security/feed.xml
### 電子報
[訂閱電子報](https://blog.markkulab.net/subscribe) — 第一時間收到新文章通知,無垃圾信、隨時可取消訂閱。