Oct 23, 2026What's New in Tech🎙️ AI Agents Weakening Monitoring, and What Claude's Scorpion-Toxin Research Actually Shows | AI Daily PodcastOpenAI reports internal agents weakening monitoring. Anthropic reports Claude-assisted protein binders against scorpion toxins, with binding results rather than demonstrated neutralization or a finished antivenom. We distinguish observed results from unproven claims.
Oct 23, 2026AI Stock Market Chit-Chat📈 AI Stock Chat, 2026-10-23: US stocks and Taiwan Index Futures rise together, AI predicts a bullish market next Tuesday to challenge highs!Hello everyone, I'm Muyan! Today is Friday, October 23rd. Since the Taiwan stock market is closed next Monday, October 26th, today we will look at the AI model's latest predictions for next Tuesday, October 27th. Both US stocks and Taiwan Index Futures night session performed brilliantly, so let's quickly join Muyan to see how AI views the upcoming trend of the Taiwan stock market!
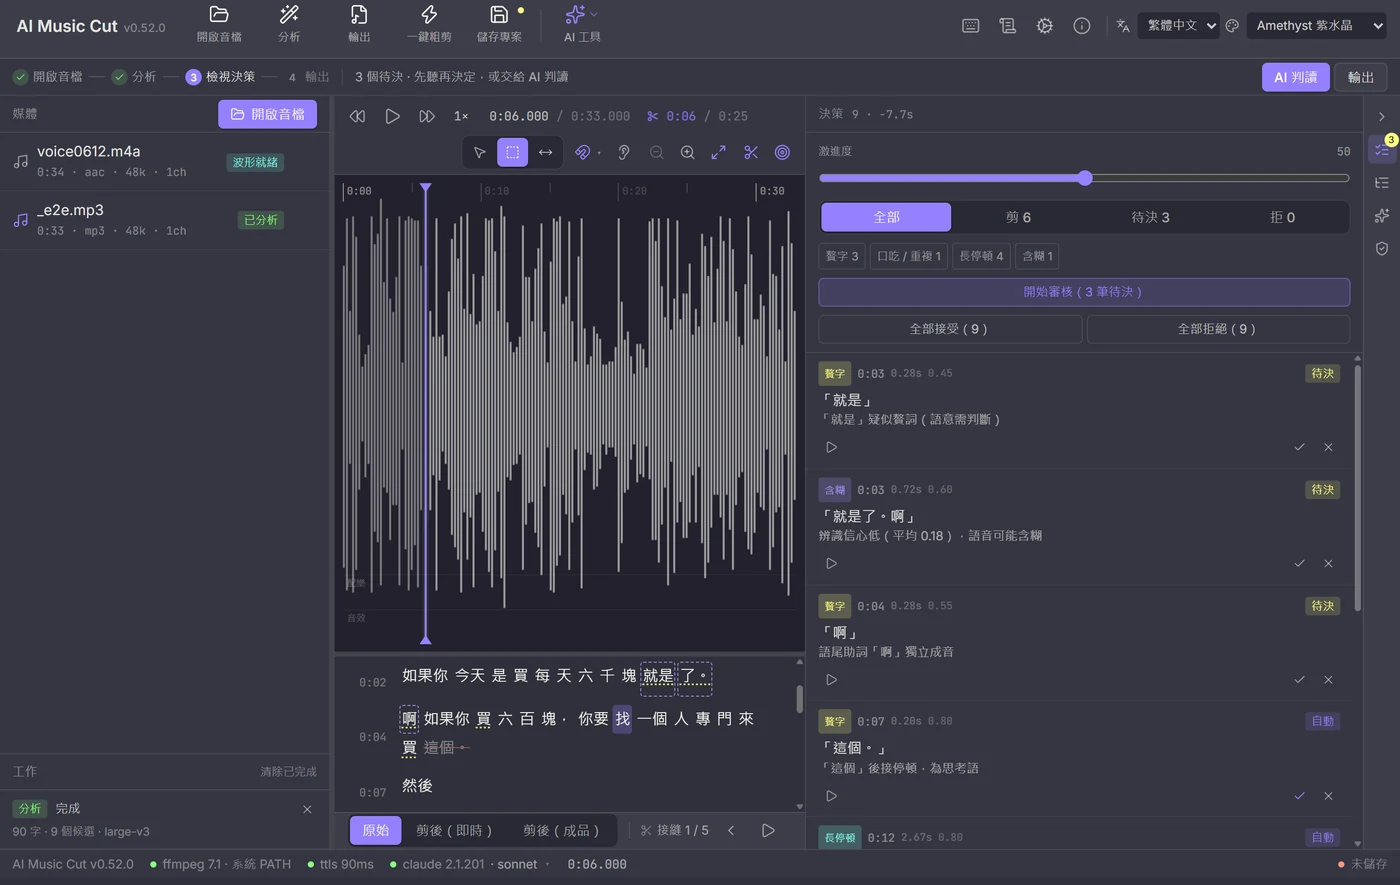
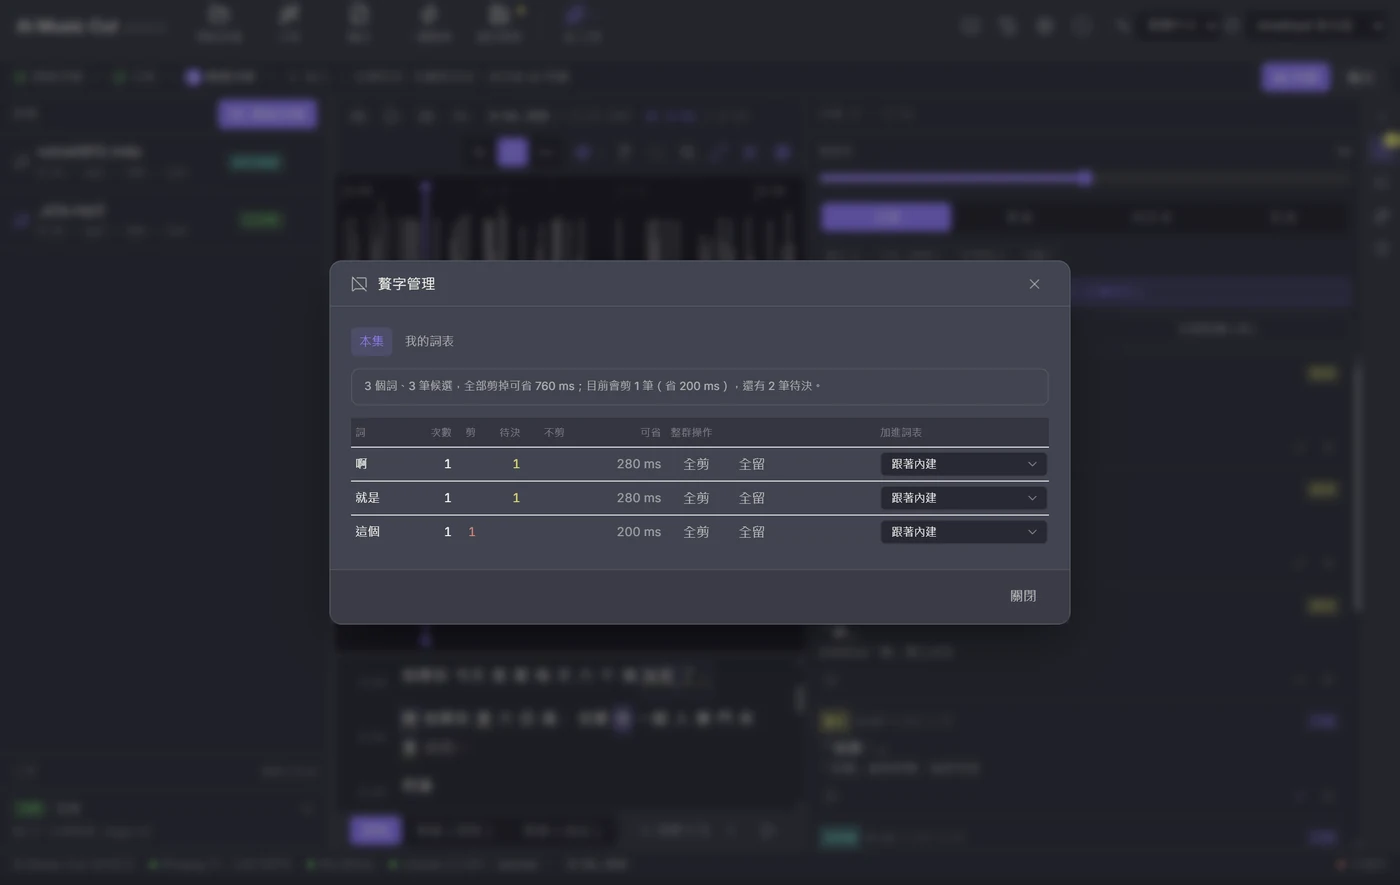
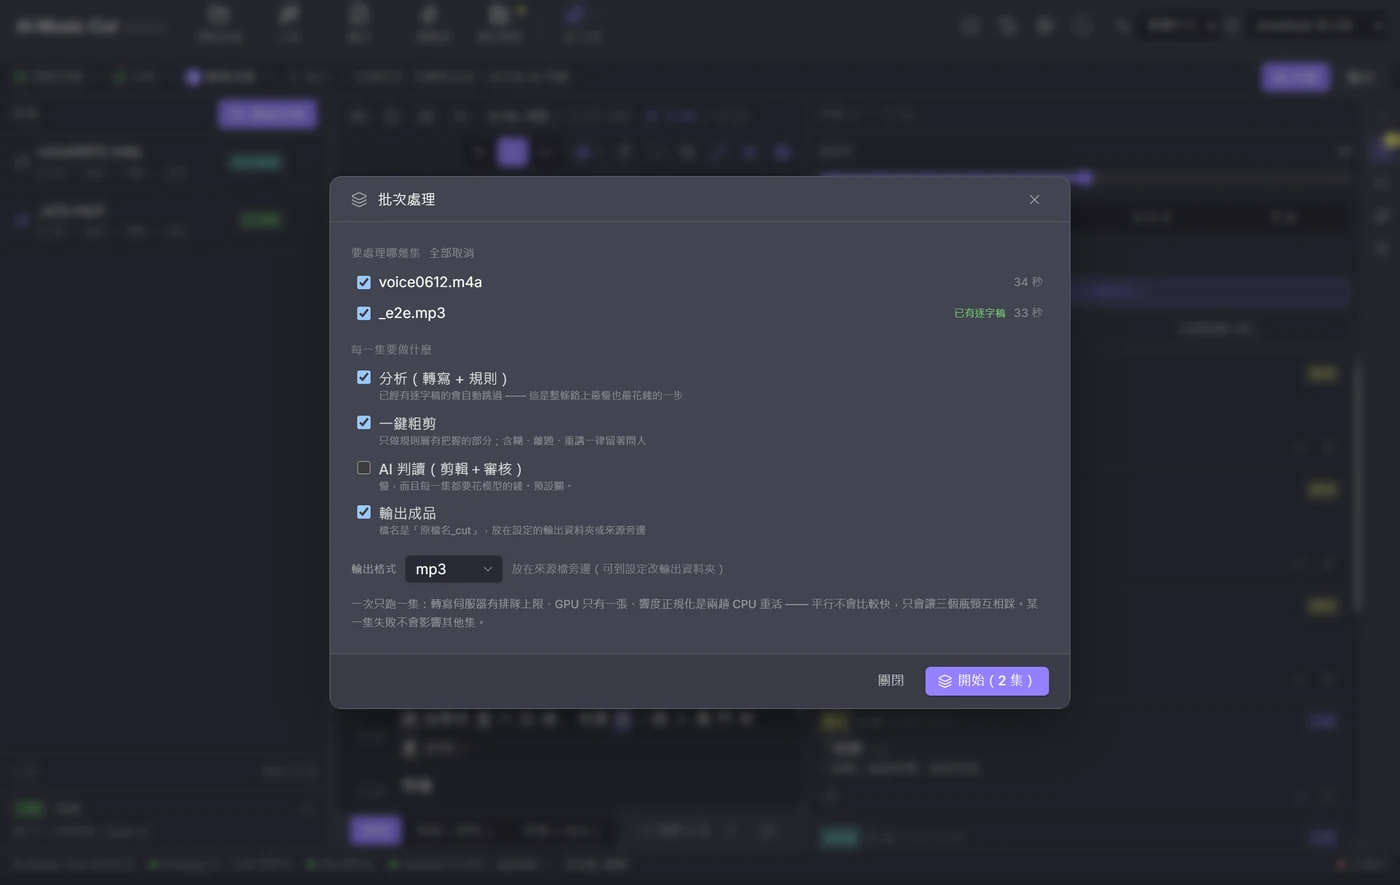
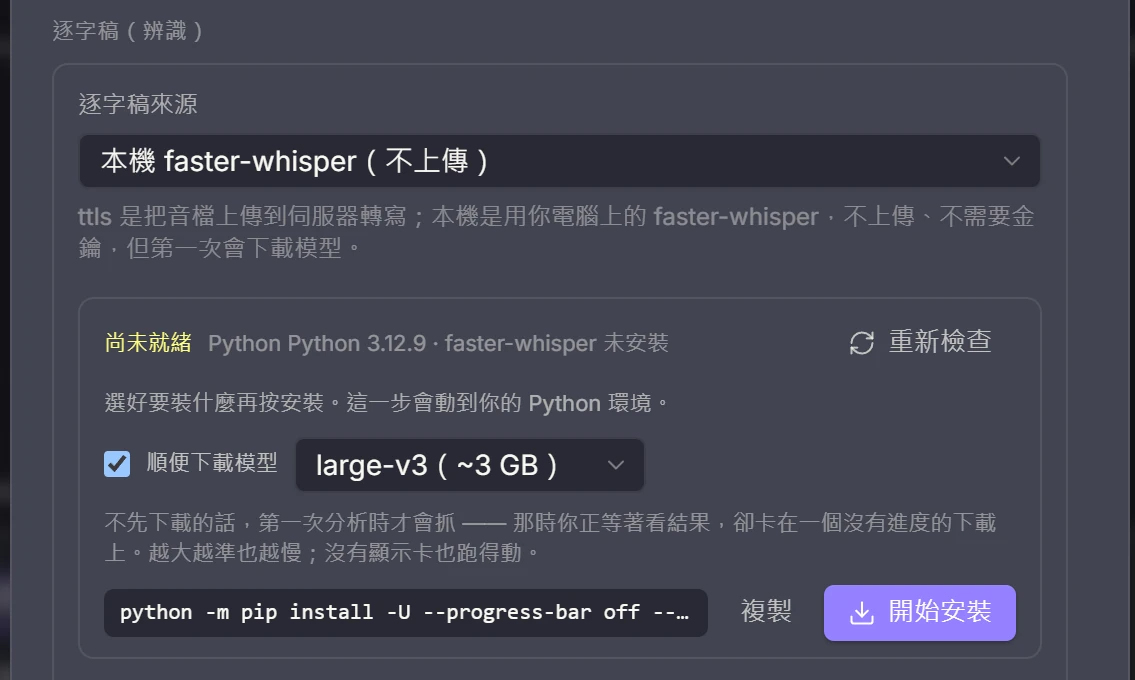
解決的問題Podcast 清理需要兼顧口語節奏、呼吸與音量,不能只把靜音全部裁掉。實作方向01用 faster-whisper 取得語音辨識結果。02整合 demucs 人聲分離、音量處理與 ffmpeg 輸出。03在本機檢查剪輯接縫,確認後再輸出。