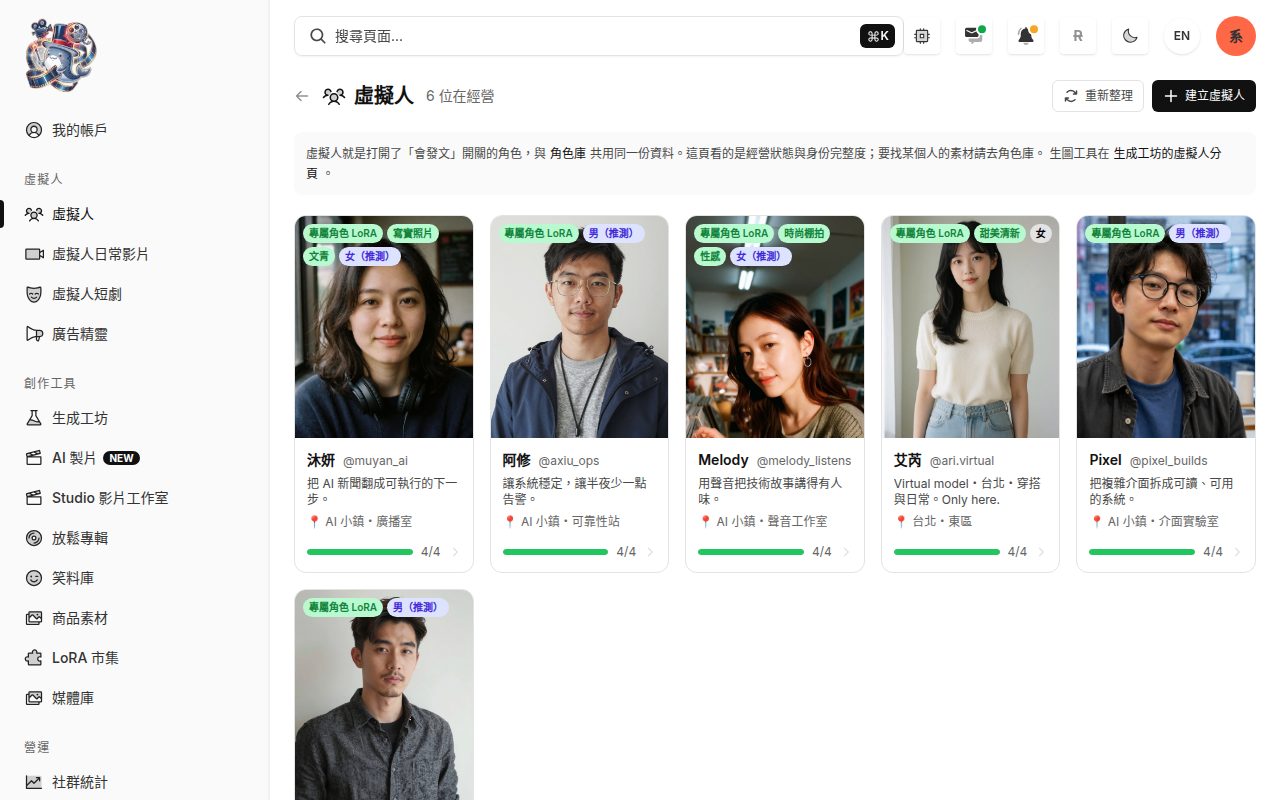
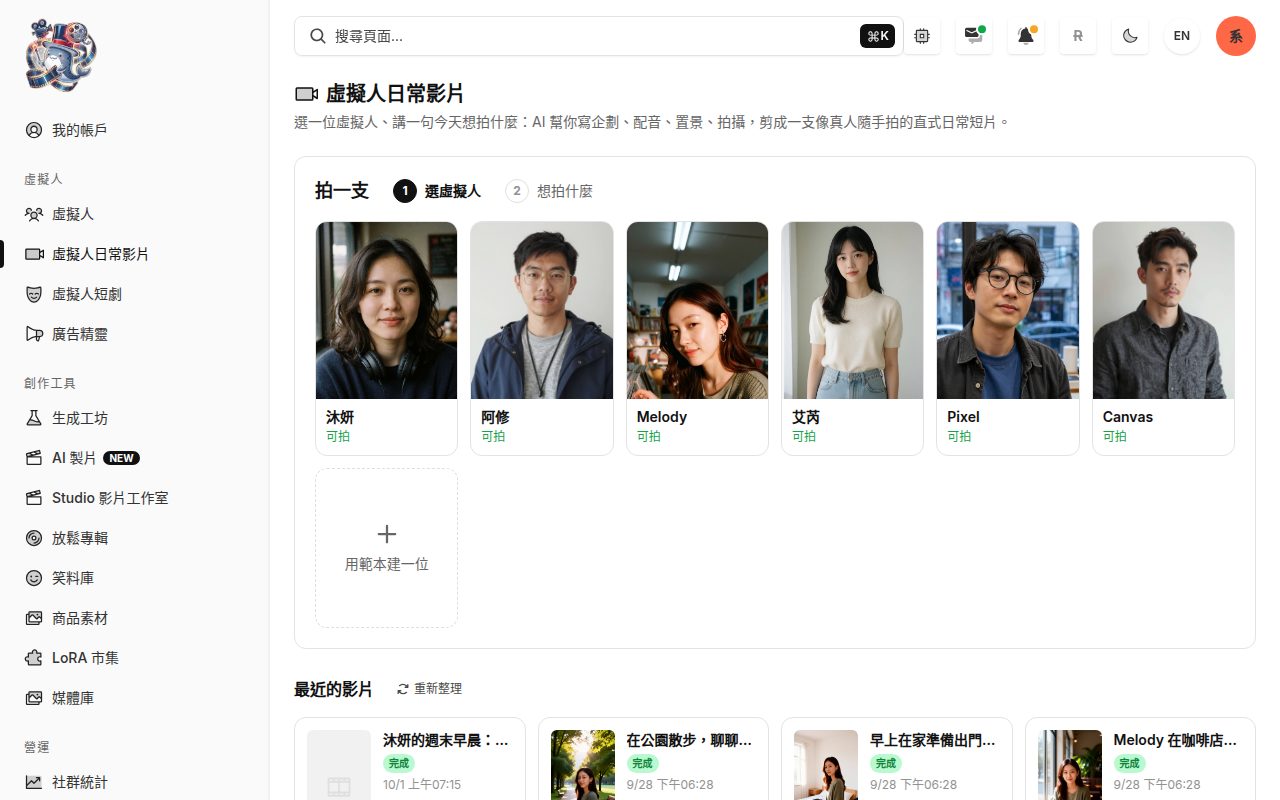
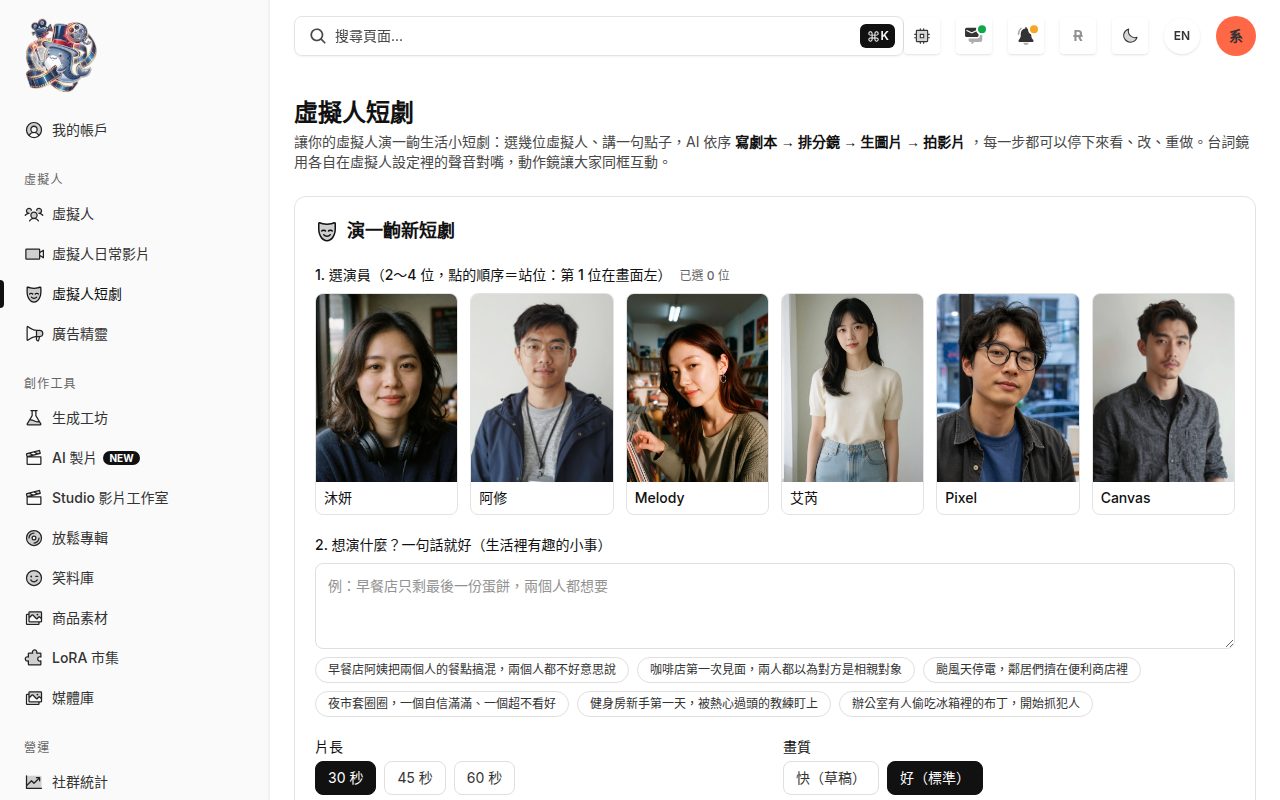
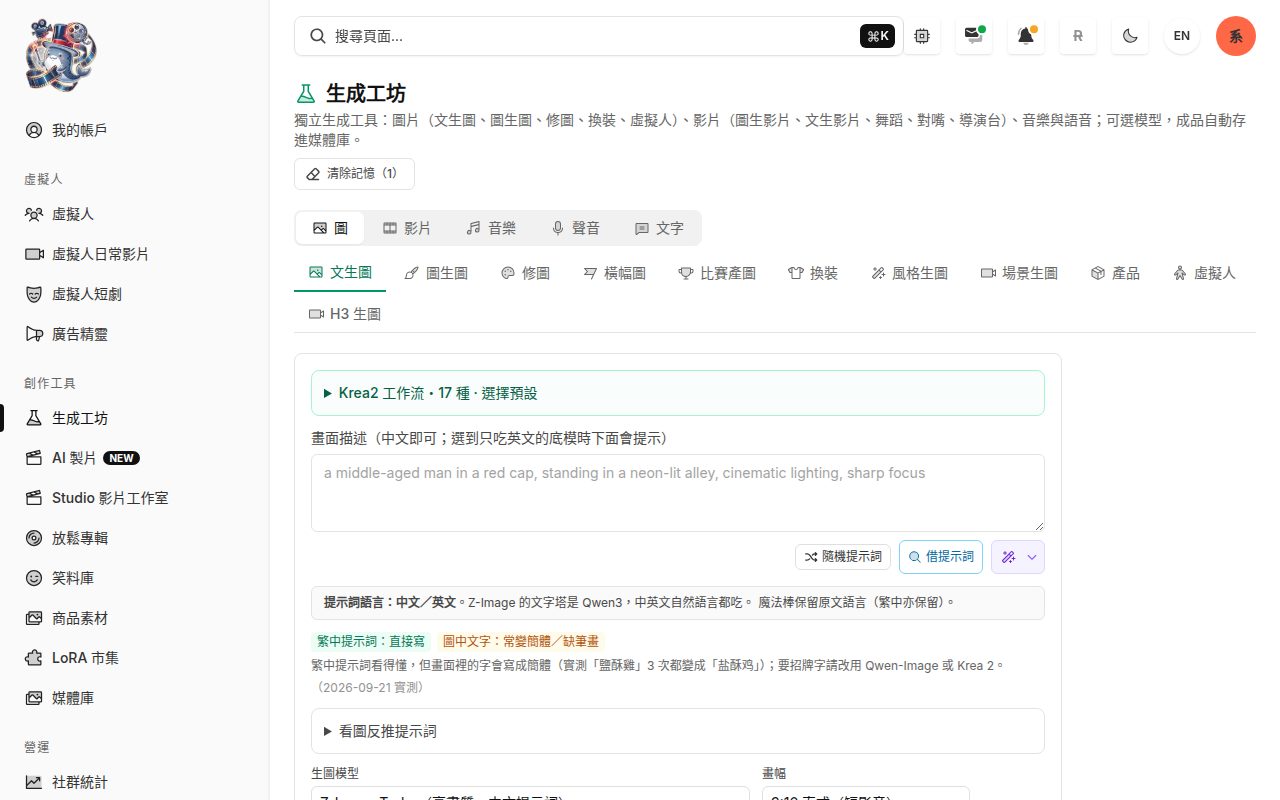
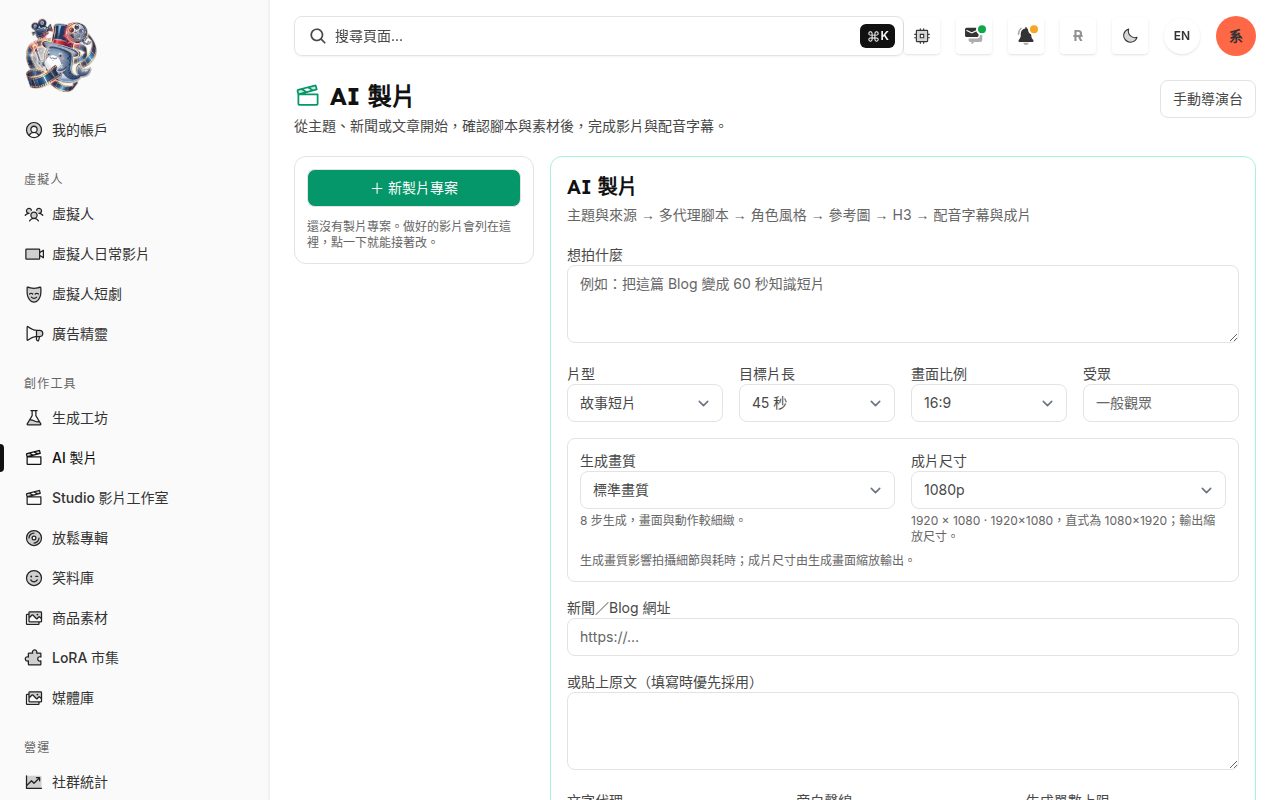
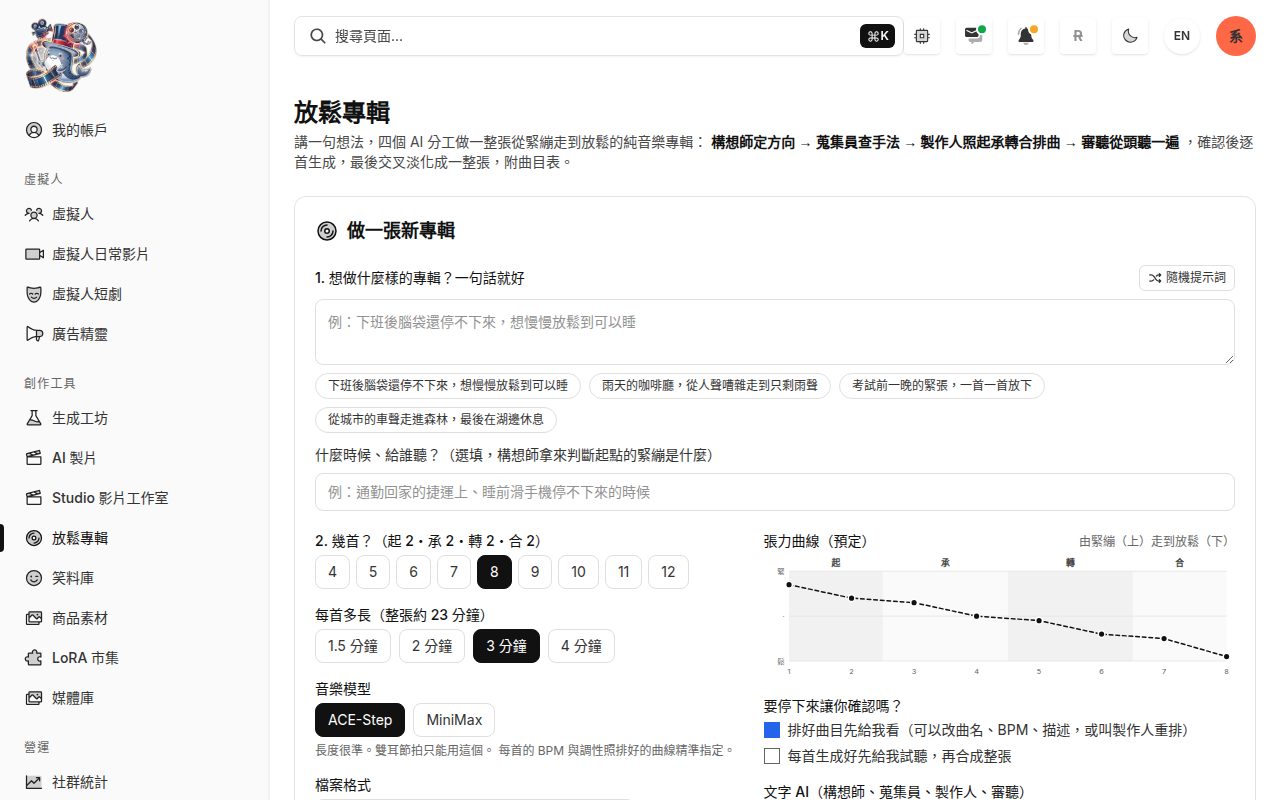
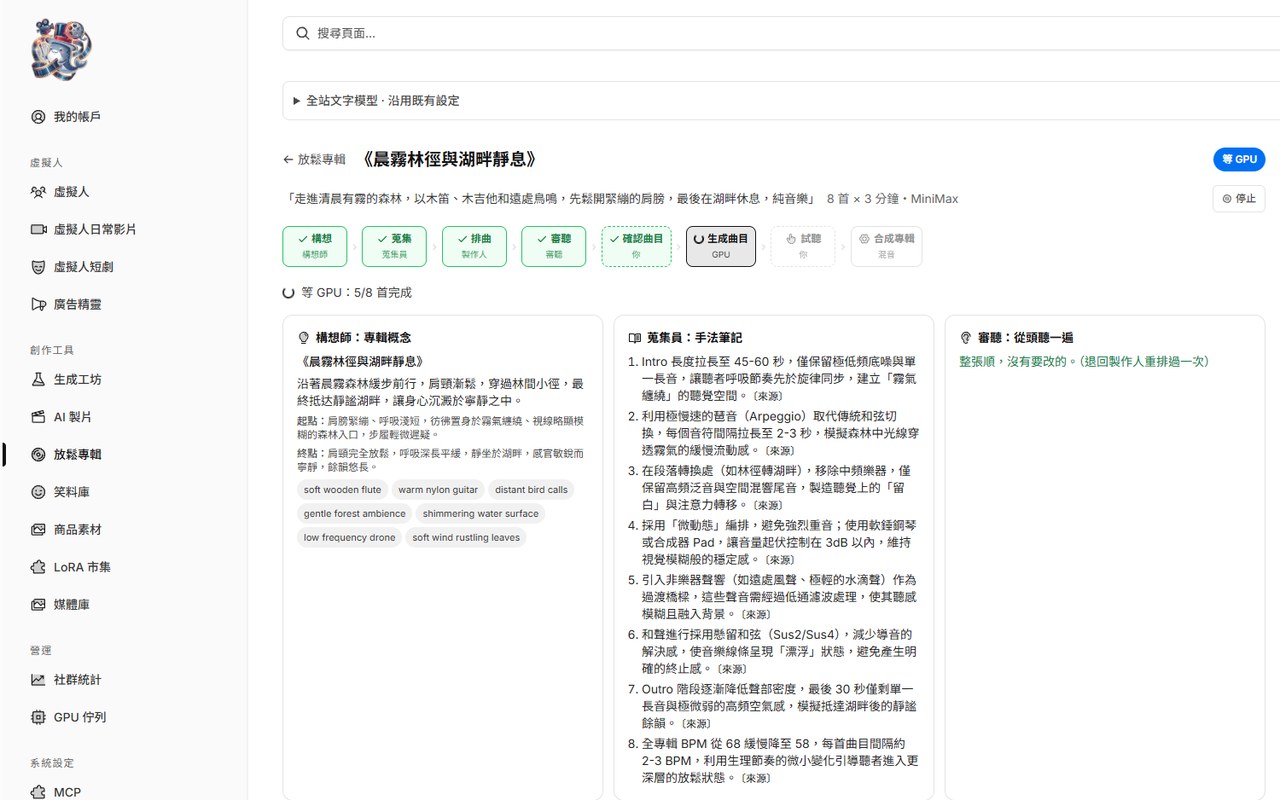
虛擬人:每位角色都有專屬 LoRA、人設與社群帳號,素材完整度一眼看得到。點擊圖片可查看原尺寸虛擬人日常影片:選一位虛擬人、講一句今天想拍什麼,剪成像隨手拍的直式短片。點擊圖片可查看原尺寸虛擬人短劇:選 2~4 位演員、講一句點子,劇本、分鏡、圖片、影片逐步確認。點擊圖片可查看原尺寸生成工坊:圖、影片、音樂、聲音分頁,生圖模型可以切換,成品自動存進媒體庫。點擊圖片可查看原尺寸AI 製片:從主題、新聞或 Blog 開始,多個 AI 代理寫腳本,最後配音、上字幕成片。點擊圖片可查看原尺寸放鬆專輯:四個 AI 分工排出從緊繃到放鬆的曲序,再用 ACE-Step 逐首生成。點擊圖片可查看原尺寸放鬆專輯製作中:構想師定概念、蒐集員整理手法、製作人排曲、審聽從頭聽一遍,確認曲目後送進 GPU 佇列逐首生成。點擊圖片可查看原尺寸
生成成果
用這個平台實際生成的短片:第一支是 AI 廣告;接著三支是虛擬人開口說話,台詞用角色的聲音、對嘴、燒上字幕;最後三支是以虛擬人的一張關鍵影格當首幀做圖生影片(MiniMax H3),每支 5 秒,沒有剪輯。
AI 廣告:帶三歲小孩去關西的親子旅遊廣告,58 秒、11 段畫面,每段有標題和字幕,最後一幕收在「立即索取行程表」。打招呼:在唱片行對著鏡頭自我介紹、請大家追蹤,一句 8 秒的台詞,字幕跟著聲音走。對嘴特寫:戴眼鏡的男生對鏡頭說話,臉拍得這麼近,嘴型和聲音一樣對得上。週末 vlog:在公園邊走邊聊三個放慢腳步的小方法,37 秒換了好幾個鏡頭,臉和聲音從頭到尾是同一個人。公園步道:她邊笑邊走向鏡頭,臉、衣服與光線都跟首幀那張關鍵影格一致。整理行李:手扶行李箱,低頭笑了一下再抬頭看鏡頭;房間與晨光從頭到尾沒有走樣。咖啡店:端起咖啡喝一口,鏡頭慢慢推近到她對鏡頭微笑;配樂與環境音也是模型一起生成的。